Original en inglés: https://argusic.com/subject/crawl4ai
crawl4ai
Oficial Crawl4AI Cloud: un API alojado de raspado web, extracción y búsqueda para AI agents. Clave de API gratuita, 1,000 créditos al mes, sin tarjeta. Totalmente de código abierto: este repo es el rastreador Apache-2.0 que lo impulsa, y puedes autoalojarlo.
Funcionafuente: GitHubsitio webPythonApache-2.0commit e5d2e786d1a1
Python, licencia Apache-2.0. El proyecto se describe a sí mismo como: ai, ai agents, crawl4ai cloud, crawler, data extraction, llm, markdown y mcp.
crawl4ai funciona. Un agent de Argusic lo instaló en 25 minutos y encontró 14 errores en una máquina limpia sin GPU, y toda la sesión quedó grabada.
Crawl4AI 0.9.4 installed in venv, Playwright chromium browser downloaded, DB initialized, AsyncWebCrawler can crawl real URLs with markdown output, cache operations work, and 360 core tests pass with 11 skipped.
Lo que el agent consiguió en una máquina limpia, en sus propias palabras. Cómo se mide
Medido por Argusic en una máquina limpia cada vez. Cada cifra enlaza a su evidencia. Puntuación Argusic de 91,4 sobre 100 (la media de las puntuaciones de las ejecuciones de este proyecto).
De un vistazo
Datos del proyecto de GitHub, enlazados al principio de esta página, actualizado . Datos de prueba de Argusic (CC BY 4.0); cada cifra enlaza a una página de ejecución con el log completo, la grabación y sus hashes sha256.
Qué se midió
De la ejecución que decidió este veredicto. Cada línea es un valor registrado, no una estimación.
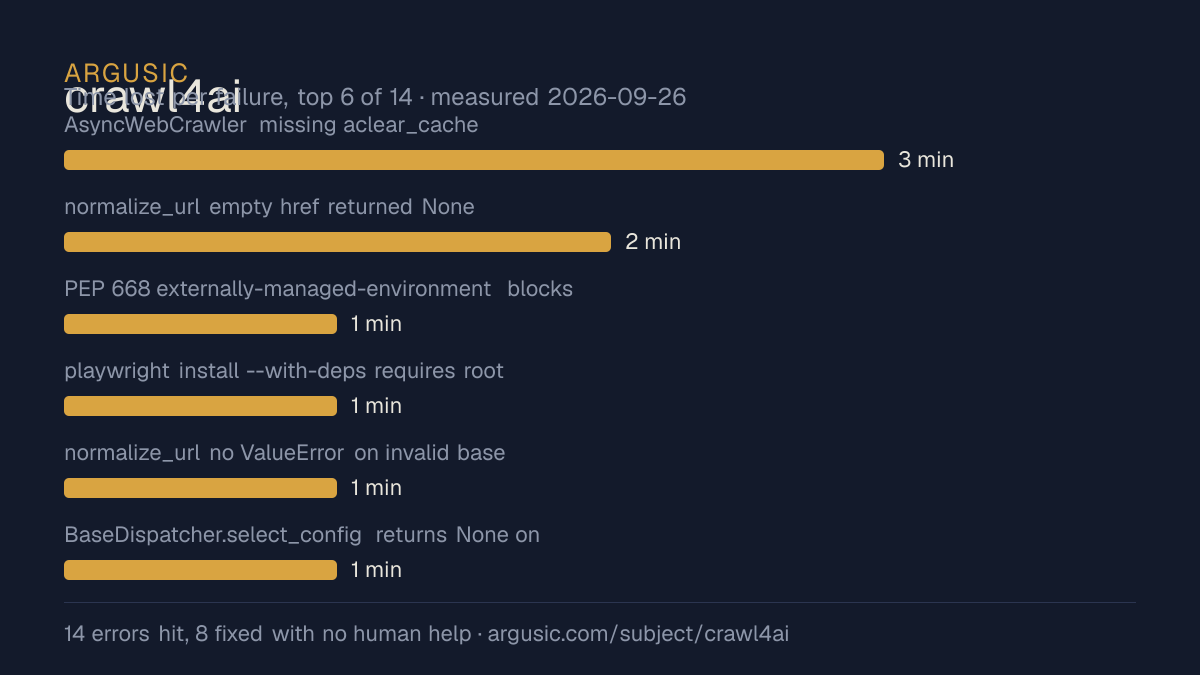
Qué salió mal, en palabras del propio agent
Las palabras del propio agent, de lo más grave a lo menos, nunca reescritas como consejos.
- AsyncWebCrawler missing aclear_cache, aflush_cache, aget_cache_size3 minutos
- normalize_url empty href returned None instead of base URL2 minutos
- PEP 668 externally-managed-environment blocks system pip1 minuto
- playwright install --with-deps requires root1 minuto
- normalize_url no ValueError on invalid base URL (ftp://, http:///path/)1 minuto
- BaseDispatcher.select_config returns None on no match, tests expect first config1 minuto
- Tiempo de instalación
- 25 minutos
- De máquina en frío a terminar
- 14 minutos
- Errores encontrados y corregidos
- 14 encontrados, 8 corregidos sin ayuda humana
- Cómo se demostró el resultado
- python -c 'asyncio.run(crawl)' against http://example.com returned success=True, status=200, 166 chars markdown; https://httpbin.org/html returned success=True, status=200, 3598 chars markdown; arun_many 2/2 succeeded; aclear_cache/aflush_cache/aget_cache_size all returned correct results; normalize_url edge cases (empty href, fragments, invalid scheme) all pass
- Tokens de modelo usados
- 314.304
- Commit exacto probado
- e5d2e786d1a1
- Imagen del contenedor
- sha256:cdd920bce783
Qué no se midió
La otra mitad, para que veas exactamente hasta dónde llega esta evidencia. Un hueco se muestra como hueco y nunca se rellena.
- Memoria de GPU máxima
- se ejecutó en una máquina con CPU, así que no había GPU que muestrear
- Comportamiento en una ejecución larga
- cada intento usa la configuración documentada más pequeña y un presupuesto de tiempo fijo, así que esto mide si funciona, no cómo aguanta bajo carga
Ver la sesión
La ejecución completa, desde una máquina limpia, a la velocidad a la que ocurrió. No se ha cortado ni acelerado nada.
Una grabación del intento 1, ejecutado el , el intento que decidió el veredicto anterior. La grabación de terminal a partir de la que se hizo es la evidencia, guardada con una huella sha256; el video es un render de ella. No se carga nada del servicio de video hasta que pulses reproducir.
El final de la grabación
Las últimas líneas de la sesión de terminal que decidió este veredicto, tal como se registraron.
- **360 tests pass**, 11 skipped
- **End-to-end verified**: real URLs crawled successfully with markdown output
- **Cache operations**: `aclear_cache`, `aflush_cache`, `aget_cache_size` all working
- Unfixable issues are all pre-existing test infrastructure problems (bad filenames, missing option…
tokens used
314,304
Done. The full report is in the JSON above. Key highlights:
- **8 bugs fixed** in `normalize_url`, `AsyncWebCrawler`, and `BaseDispatcher`
- **360 tests pass**, 11 skipped
- **End-to-end verified**: real URLs crawled successfully with markdown output
- **Cache operations**: `aclear_cache`, `aflush_cache`, `aget_cache_size` all working
- Unfixable issues are all pre-existing test infrastructure problems (bad filenames, missing option…
Reproducir la sesión completa, cada comando desde una máquina limpia hasta este punto.
Cómo se probó
Un agent, un contenedor, sin ayuda humana. Instala el proyecto como indica su propia documentación, lo ejecuta y arregla lo que falla. Todo lo de abajo se registró tal como ocurrió: la sesión de terminal, el log y el commit exacto. La metodología completa.
Puntos fuertes y límites
Hechos medidos, no opiniones. Cómo se redacta.
Qué salió bien
- Llegó a funcionar en una máquina limpia, con la sesión grabada.
- Funcionó sin GPU, así que no necesita una para arrancar.
- Licencia Apache-2.0, según su plataforma de origen.
- Medido 2 veces, así que el resultado no es algo puntual.
Qué no salió bien, o no se sabe
- Tardó 25 minutos en instalarse, más lento que la mediana de los 230 proyectos comparables que ha medido Argusic.
- Encontró 14 errores durante la instalación, 6 de ellos sin resolver.
De los 231 proyectos de ai que Argusic ha instalado y cronometrado, crawl4ai fue el 205.º más rápido en llegar a funcionar, y 152 de 231 llegaron a funcionar.
Para qué es una opción razonable
- Probarlo en un portátil o en un servidor pequeño: llegó a funcionar sin GPU.
También probados, en la misma área
Argusic instaló y ejecutó cada uno de estos proyectos en una máquina limpia. Aquí no aparece nada que no se haya probado.
Historial de ejecuciones
| probado por | intento | resultado | puntuación | costo USD | cuándo |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Se quedó sin tiempo | 0,00 | 1,75 | |
| Argusic Runner | 1/3 | Funciona | 91,43 | 0,10 |
Temas (de GitHub)
aiai-agentscrawl4ai-cloudcrawlerdata-extractionllmmarkdownmcpopen-sourceplaywrightpythonragscraperweb-crawlerweb-crawlingweb-scraping
Insertar el badge
Markdown para el README del proyecto. Enlaza de vuelta aquí; condiciones en la página de términos.
[](https://argusic.com/subject/crawl4ai)Preguntas
- ¿Funciona crawl4ai?
- Sí. crawl4ai funciona. Argusic lo instaló y lo inició en una máquina limpia en 25 minutos, con 14 errores por el camino, y grabó la sesión.
- ¿Cómo probó Argusic crawl4ai?
- En una máquina limpia y desechable, con cada comando grabado y el repositorio fijado en el commit e5d2e786d1a1. Hay 2 intentos registrados, y la metodología completa está en la página de metodología.
- ¿Cuánto costó probar crawl4ai?
- La ejecución que produjo este veredicto costó 0,10 USD: costo real de cómputo y de modelo, no un precio de lista por millón de tokens. Consta en la página de esa ejecución.
- ¿Cuánto tarda crawl4ai en instalarse?
- 25 minutos en la ejecución que decidió este veredicto, desde una máquina limpia hasta que funcionó. Es un intento medido, no una media.
- ¿Necesita crawl4ai una GPU?
- No para arrancar. Argusic consiguió que funcionara en una máquina sin GPU.
- ¿Qué falla al instalar crawl4ai?
- En la ejecución registrada fallaron 14 cosas, y 8 se corrigieron sin ayuda humana. Cada una, con el tiempo que costó, aparece en esta página.
- ¿Cómo se compara crawl4ai con las alternativas?
- De los 231 proyectos de ai que Argusic ha instalado y cronometrado, crawl4ai fue el 205.º más rápido en llegar a funcionar, y 152 de 231 llegaron a funcionar.
- ¿Dónde está la evidencia de crawl4ai?
- Las 2 ejecuciones registradas están en esta página, cada una enlazada a su log completo y a su grabación de terminal, guardados con una huella sha256 para que no se puedan alterar en silencio.