Original em inglês: https://argusic.com/subject/crawl4ai
crawl4ai
Official Crawl4AI Cloud: uma API hospedada de raspagem de dados da web, extração e busca para AI agents. Chave de API gratuita, 1,000 créditos por mês, sem cartão. Totalmente código aberto: este repo é o rastreador Apache-2.0 que o alimenta, e você pode auto-hospedá-lo.
Executafonte: GitHubpágina do projetoPythonApache-2.0commit e5d2e786d1a1
Python, licença Apache-2.0. O projeto se descreve como: ai, ai agents, crawl4ai cloud, crawler, data extraction, llm, markdown e mcp.
crawl4ai executa. Em uma máquina limpa sem GPU, um agent da Argusic o instalou em 25 minutos e encontrou 14 erros, e a sessão inteira foi gravada.
Crawl4AI 0.9.4 installed in venv, Playwright chromium browser downloaded, DB initialized, AsyncWebCrawler can crawl real URLs with markdown output, cache operations work, and 360 core tests pass with 11 skipped.
O que o agent conseguiu em uma máquina limpa, nas palavras dele. Como isto é medido
Medido pela Argusic em uma máquina nova, todas as vezes. Cada número tem link para as suas evidências. Pontuação Argusic 91,4 de 100 (a média das pontuações das execuções deste projeto).
Visão geral
Dados do projeto de GitHub, com link no topo desta página, atualizado em . Dados de teste da Argusic (CC BY 4.0); cada número tem link para uma página de execução com o log completo, a gravação e os hashes sha256 deles.
O que foi medido
Da execução que decidiu este veredito. Cada linha é um valor registrado, não uma estimativa.
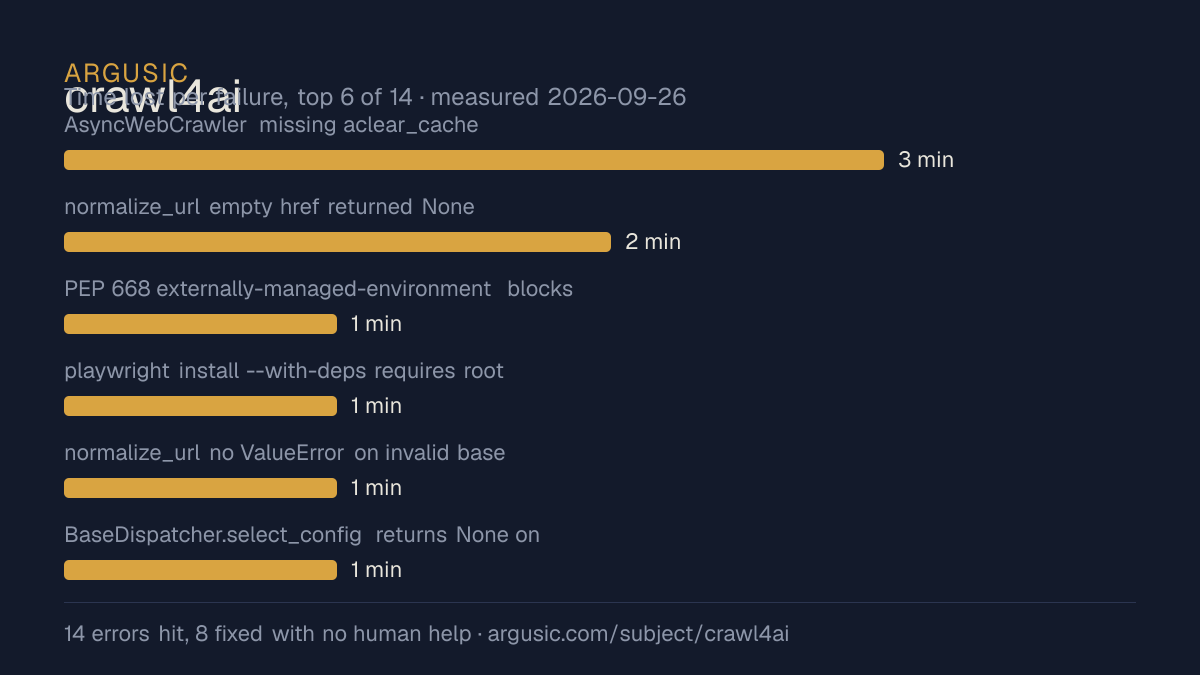
O que deu errado, nas palavras do agent
As palavras do próprio agent, das piores para as menores, nunca reescritas como conselho.
- AsyncWebCrawler missing aclear_cache, aflush_cache, aget_cache_size3 minutos
- normalize_url empty href returned None instead of base URL2 minutos
- PEP 668 externally-managed-environment blocks system pip1 minuto
- playwright install --with-deps requires root1 minuto
- normalize_url no ValueError on invalid base URL (ftp://, http:///path/)1 minuto
- BaseDispatcher.select_config returns None on no match, tests expect first config1 minuto
- Tempo de instalação
- 25 minutos
- Da máquina limpa até o fim
- 14 minutos
- Erros encontrados e corrigidos
- 14 encontrados, 8 corrigidos sem ajuda humana
- Como o resultado foi comprovado
- python -c 'asyncio.run(crawl)' against http://example.com returned success=True, status=200, 166 chars markdown; https://httpbin.org/html returned success=True, status=200, 3598 chars markdown; arun_many 2/2 succeeded; aclear_cache/aflush_cache/aget_cache_size all returned correct results; normalize_url edge cases (empty href, fragments, invalid scheme) all pass
- Tokens de modelo usados
- 314.304
- Commit exato testado
- e5d2e786d1a1
- Imagem do container
- sha256:cdd920bce783
O que não foi medido
A outra metade, para você ver exatamente até onde estas evidências vão. Uma lacuna é mostrada como lacuna e nunca é preenchida.
- Pico de memória da GPU
- esta execução foi em uma máquina com CPU, então não havia GPU para medir
- Comportamento em uma execução longa
- cada tentativa usa as menores configurações documentadas e um orçamento de tempo fixo, então isto mede se ele executa, não como ele se comporta sob carga
Assista à sessão
A execução inteira, a partir de uma máquina limpa, na velocidade em que realmente aconteceu. Nada é cortado e nada é acelerado.
Uma gravação da tentativa 1, executada em , a tentativa que decidiu o veredito acima. A gravação do terminal da qual ele foi feito é a evidência, guardada com uma impressão digital sha256; o vídeo é uma renderização dela. Nada é carregado do serviço de vídeo até você apertar o play.
O fim da gravação
As últimas linhas da sessão de terminal que decidiu este veredito, exatamente como foram gravadas.
- **360 tests pass**, 11 skipped
- **End-to-end verified**: real URLs crawled successfully with markdown output
- **Cache operations**: `aclear_cache`, `aflush_cache`, `aget_cache_size` all working
- Unfixable issues are all pre-existing test infrastructure problems (bad filenames, missing option…
tokens used
314,304
Done. The full report is in the JSON above. Key highlights:
- **8 bugs fixed** in `normalize_url`, `AsyncWebCrawler`, and `BaseDispatcher`
- **360 tests pass**, 11 skipped
- **End-to-end verified**: real URLs crawled successfully with markdown output
- **Cache operations**: `aclear_cache`, `aflush_cache`, `aget_cache_size` all working
- Unfixable issues are all pre-existing test infrastructure problems (bad filenames, missing option…
Reproduzir a sessão inteira, cada comando desde a máquina limpa até este ponto.
Como foi testado
Um agent, um container, nenhuma ajuda humana. Ele instala o projeto do jeito que a própria documentação do projeto manda, executa o projeto e corrige o que quebra. Tudo abaixo é registrado como aconteceu: a sessão de terminal, o log e o commit exato. A metodologia completa.
Pontos fortes e limites
Fatos medidos, não opiniões. Como este conteúdo é escrito.
O que deu certo
- Chegou a um estado de execução em uma máquina limpa, com a sessão gravada.
- Executou sem GPU, então não precisa de uma para iniciar.
- Licença Apache-2.0, segundo a plataforma onde o projeto está hospedado.
- Medido 2 vezes, então o resultado não é um caso isolado.
O que não deu certo, ou não se sabe
- Levou 25 minutos para instalar, mais devagar que a mediana dos 230 projetos comparáveis que a Argusic mediu.
- Encontrou 14 erros durante a configuração, 6 dos quais não foram resolvidos.
Dos 231 projetos de ai que a Argusic instalou e cronometrou, crawl4ai foi o 205º mais rápido a chegar a um estado de execução, e 152 de 231 chegaram a esse estado.
Para que é uma escolha razoável
- Testar em um laptop ou em um servidor pequeno: ele chegou a um estado de execução sem GPU.
Também testados, na mesma área
Cada um destes foi instalado e executado pela Argusic em uma máquina limpa. Nada aparece aqui sem ter sido testado.
Histórico de execuções
| testado por | tentativa | resultado | pontuação | custo USD | quando |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Tempo esgotado | 0,00 | 1,75 | |
| Argusic Runner | 1/3 | Executa | 91,43 | 0,10 |
Tópicos (de GitHub)
aiai-agentscrawl4ai-cloudcrawlerdata-extractionllmmarkdownmcpopen-sourceplaywrightpythonragscraperweb-crawlerweb-crawlingweb-scraping
Incorporar o selo
Markdown para o README do projeto. Ele tem link de volta para esta página; os termos estão na página de termos.
[](https://argusic.com/subject/crawl4ai)Perguntas
- crawl4ai executa?
- Sim. crawl4ai executa. A Argusic o instalou e iniciou em uma máquina limpa em 25 minutos, encontrando 14 erros no caminho, e gravou a sessão.
- Como a Argusic testou crawl4ai?
- Em uma máquina nova e descartável, com cada comando gravado e o repositório fixado no commit e5d2e786d1a1. Há 2 tentativas registradas, e a metodologia completa está na página da metodologia.
- Quanto custou testar crawl4ai?
- A execução que produziu este veredito custou US$ 0,10: custo real de computação e de modelo, não um preço de tabela por milhão de tokens. Esse valor está registrado na página da execução.
- Quanto tempo leva para instalar crawl4ai?
- 25 minutos na execução que decidiu este veredito, de uma máquina limpa até um estado de execução. É uma tentativa medida, não uma média.
- crawl4ai precisa de GPU?
- Não para iniciar. A Argusic chegou a um estado de execução em uma máquina sem GPU.
- O que dá errado ao instalar crawl4ai?
- 14 coisas quebraram na execução registrada, e 8 foram corrigidas sem ajuda humana. Cada uma, com o tempo que custou, está listada nesta página.
- Como crawl4ai se compara às alternativas?
- Dos 231 projetos de ai que a Argusic instalou e cronometrou, crawl4ai foi o 205º mais rápido a chegar a um estado de execução, e 152 de 231 chegaram a esse estado.
- Onde estão as evidências de crawl4ai?
- Todas as 2 execuções registradas estão nesta página, cada uma com link para o seu log completo e a sua gravação do terminal, guardados com uma impressão digital sha256 para que não possam ser alterados discretamente.