Original en inglés: https://argusic.com/subject/scrapling
Scrapling
El MEJOR framework de web scraping que maneja todo, desde una sola solicitud hasta un rastreo a gran escala.
Funcionafuente: GitHubsitio webPythonBSD-3-Clausecommit 458e2a2ac909
Python, licencia BSD-3-Clause. El proyecto se describe a sí mismo como: ai, ai scraping, automation, crawler, crawling, crawling python, data y data extraction.
Scrapling funciona. Un agent de Argusic lo instaló en 10 minutos y encontró 2 errores, todos corregidos sin ayuda en una máquina limpia sin GPU, y toda la sesión quedó grabada.
Scrapling 0.4.15 is installed in a venv with all extras, Playwright Chromium browser available, all 985 tests pass, CLI and MCP server commands respond correctly, and HTTP fetches via StealthyFetcher return status 200 from real endpoints.
Lo que el agent consiguió en una máquina limpia, en sus propias palabras. Cómo se mide
Medido por Argusic en una máquina limpia cada vez. Cada cifra enlaza a su evidencia. Puntuación Argusic de 96 sobre 100 (la media de las puntuaciones de las ejecuciones de este proyecto).
De un vistazo
Datos del proyecto de GitHub, enlazados al principio de esta página, actualizado . Datos de prueba de Argusic (CC BY 4.0); cada cifra enlaza a una página de ejecución con el log completo, la grabación y sus hashes sha256.
Qué se midió
De la ejecución que decidió este veredicto. Cada línea es un valor registrado, no una estimación.
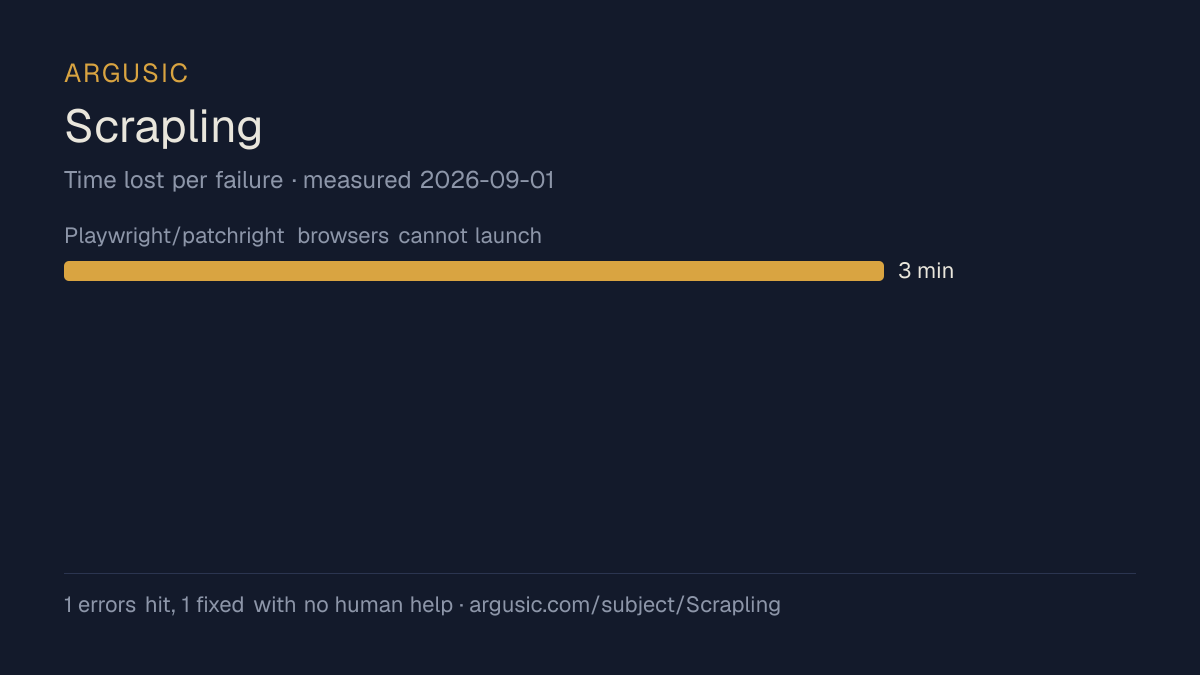
Qué salió mal, en palabras del propio agent
Las palabras del propio agent, de lo más grave a lo menos, nunca reescritas como consejos.
- Tests fail with 'real_chrome=True' - no system Chrome installed at /opt/google/chrome/chrome2 minutos
- Playwright install-deps requires sudo for system libraries (libnss3, etc.)1 minuto
- Tiempo de instalación
- 10 minutos
- De máquina en frío a terminar
- 8 minutos
- Errores encontrados y corregidos
- 2 encontrados, 2 corregidos sin ayuda humana
- Cómo se demostró el resultado
- pytest tests/ -v exited 0, 985 passed in 87.33s; scrapling --version returned 'Scrapling, version 0.4.15'; StealthyFetcher.fetch('https://httpbin.org/html').status returned 200
- Tokens de modelo usados
- 382.494
- Commit exacto probado
- 458e2a2ac909
- Imagen del contenedor
- sha256:cdd920bce783
Qué no se midió
La otra mitad, para que veas exactamente hasta dónde llega esta evidencia. Un hueco se muestra como hueco y nunca se rellena.
- Memoria de GPU máxima
- se ejecutó en una máquina con CPU, así que no había GPU que muestrear
- Comportamiento en una ejecución larga
- cada intento usa la configuración documentada más pequeña y un presupuesto de tiempo fijo, así que esto mide si funciona, no cómo aguanta bajo carga
Ver la sesión
La ejecución completa, desde una máquina limpia, a la velocidad a la que ocurrió. No se ha cortado ni acelerado nada.
Una grabación del intento 2, ejecutado el , el intento que decidió el veredicto anterior. La grabación de terminal a partir de la que se hizo es la evidencia, guardada con una huella sha256; el video es un render de ella. No se carga nada del servicio de video hasta que pulses reproducir.
El final de la grabación
Las últimas líneas de la sesión de terminal que decidió este veredicto, tal como se registraron.
**Verification**: Full test suite passed — all 985 tests across parser, core, CLI, fetchers, spider…
```json
```
tokens used
382,494
That's fine, it's just a marker file anyway. Let me produce the final report.
Here's a summary of everything I did:
**Installation**: I created a Python virtual environment at `/home/runner/venv` (since the system P…
**Error encountered & fixed**: The test files for `DynamicFetcher` used `real_chrome=True` in their…
**Verification**: Full test suite passed — all 985 tests across parser, core, CLI, fetchers, spider…
```json
```
Reproducir la sesión completa, cada comando desde una máquina limpia hasta este punto.
Cómo se probó
Un agent, un contenedor, sin ayuda humana. Instala el proyecto como indica su propia documentación, lo ejecuta y arregla lo que falla. Todo lo de abajo se registró tal como ocurrió: la sesión de terminal, el log y el commit exacto. La metodología completa.
Puntos fuertes y límites
Hechos medidos, no opiniones. Cómo se redacta.
Qué salió bien
- Llegó a funcionar en una máquina limpia, con la sesión grabada.
- Se recuperó de los 2 errores sin que interviniera una persona, lo que indica que los fallos están lo bastante documentados como para resolverlos.
- Funcionó sin GPU, así que no necesita una para arrancar.
- Licencia BSD-3-Clause, según su plataforma de origen.
- Medido 2 veces, así que el resultado no es algo puntual.
Qué no salió bien, o no se sabe
- Tardó 10 minutos en instalarse, más lento que la mediana de los 230 proyectos comparables que ha medido Argusic.
De los 231 proyectos de ai que Argusic ha instalado y cronometrado, Scrapling fue el 154.º más rápido en llegar a funcionar, y 152 de 231 llegaron a funcionar.
Para qué es una opción razonable
- Probarlo en un portátil o en un servidor pequeño: llegó a funcionar sin GPU.
- Una evaluación rápida: estaba funcionando 10 minutos después del clon.
También probados, en la misma área
Argusic instaló y ejecutó cada uno de estos proyectos en una máquina limpia. Aquí no aparece nada que no se haya probado.
Historial de ejecuciones
| probado por | intento | resultado | puntuación | costo USD | cuándo |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Funciona | 100,00 | 0,08 | |
| Argusic Runner | 1/3 | Funciona con mocks | 92,00 | 0,11 |
Temas (de GitHub)
aiai-scrapingautomationcrawlercrawlingcrawling-pythondatadata-extractionmcpmcp-serverplaywrightpythonscrapingselectorsstealthweb-scraperweb-scrapingweb-scraping-pythonwebscrapingxpath
Insertar el badge
Markdown para el README del proyecto. Enlaza de vuelta aquí; condiciones en la página de términos.
[](https://argusic.com/subject/scrapling)Preguntas
- ¿Funciona Scrapling?
- Sí. Scrapling funciona. Argusic lo instaló y lo inició en una máquina limpia en 10 minutos, con 2 errores por el camino, y grabó la sesión.
- ¿Cómo probó Argusic Scrapling?
- En una máquina limpia y desechable, con cada comando grabado y el repositorio fijado en el commit 458e2a2ac909. Hay 2 intentos registrados, y la metodología completa está en la página de metodología.
- ¿Cuánto costó probar Scrapling?
- La ejecución que produjo este veredicto costó 0,08 USD: costo real de cómputo y de modelo, no un precio de lista por millón de tokens. Consta en la página de esa ejecución.
- ¿Cuánto tarda Scrapling en instalarse?
- 10 minutos en la ejecución que decidió este veredicto, desde una máquina limpia hasta que funcionó. Es un intento medido, no una media.
- ¿Necesita Scrapling una GPU?
- No para arrancar. Argusic consiguió que funcionara en una máquina sin GPU.
- ¿Qué falla al instalar Scrapling?
- En la ejecución registrada fallaron 2 cosas, y 2 se corrigieron sin ayuda humana. Cada una, con el tiempo que costó, aparece en esta página.
- ¿Cómo se compara Scrapling con las alternativas?
- De los 231 proyectos de ai que Argusic ha instalado y cronometrado, Scrapling fue el 154.º más rápido en llegar a funcionar, y 152 de 231 llegaron a funcionar.
- ¿Dónde está la evidencia de Scrapling?
- Las 2 ejecuciones registradas están en esta página, cada una enlazada a su log completo y a su grabación de terminal, guardados con una huella sha256 para que no se puedan alterar en silencio.