英文原文: https://argusic.com/subject/crawl4ai
crawl4ai
官方 Crawl4AI Cloud:一个面向 AI agents 的托管网页抓取、提取和搜索 API。免费 API 密钥,每月 1,000 积分,无需信用卡。完全开源:这个 repo 就是驱动它的 Apache-2.0 爬虫,你可以自托管它。
可运行来源:GitHub项目主页PythonApache-2.0commit e5d2e786d1a1
Python,Apache-2.0 许可证. 项目的自我描述:ai、ai agents、crawl4ai cloud、crawler、data extraction、llm、markdown 和 mcp.
crawl4ai 可以运行。一个 Argusic agent 在一台没有 GPU 的干净机器上用 25 分钟完成了安装,遇到 14 个错误,整个会话都被记录了下来。
Crawl4AI 0.9.4 installed in venv, Playwright chromium browser downloaded, DB initialized, AsyncWebCrawler can crawl real URLs with markdown output, cache operations work, and 360 core tests pass with 11 skipped.
agent 在干净的机器上最终得到的结果,用它自己的话说。 测量方式
每一次都由 Argusic 在全新机器上实测。每个数字都链接到对应的证据。 Argusic 评分 91.4,满分 100(该项目各次运行得分的平均值)。
概览
项目数据来自 GitHub,链接见本页顶部,更新于 。测试数据由 Argusic 提供 (CC BY 4.0);每个数字都链接到一个运行页面,附完整的 log、录屏及其 sha256 哈希。
测量了什么
来自决定该结论的那次运行。 每一行都是记录下来的数值,而非估算。
哪里出了问题,用 agent 自己的话说
agent 的原话,最严重的排在最前,从不改写成建议。
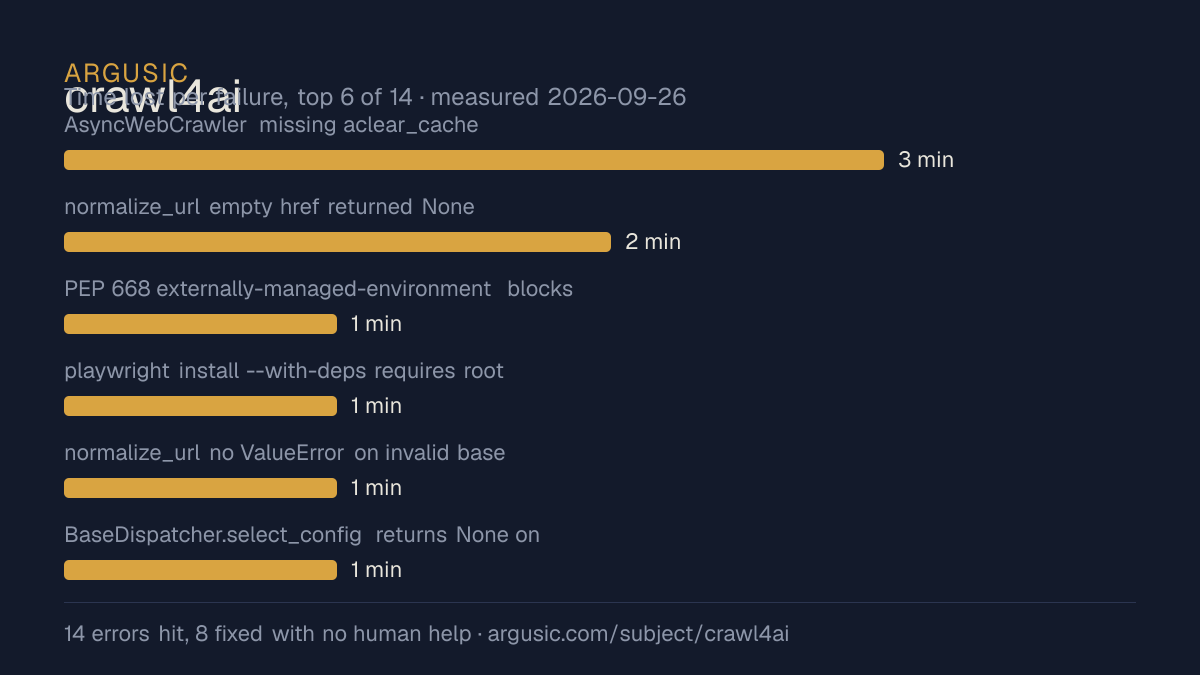
- AsyncWebCrawler missing aclear_cache, aflush_cache, aget_cache_size3 分钟
- normalize_url empty href returned None instead of base URL2 分钟
- PEP 668 externally-managed-environment blocks system pip1 分钟
- playwright install --with-deps requires root1 分钟
- normalize_url no ValueError on invalid base URL (ftp://, http:///path/)1 分钟
- BaseDispatcher.select_config returns None on no match, tests expect first config1 分钟
- 安装时间
- 25 分钟
- 从冷启动机器到完成
- 14 分钟
- 遇到并修复的错误
- 遇到 14 个,在无人协助的情况下修复了 8 个
- 结果是如何证明的
- python -c 'asyncio.run(crawl)' against http://example.com returned success=True, status=200, 166 chars markdown; https://httpbin.org/html returned success=True, status=200, 3598 chars markdown; arun_many 2/2 succeeded; aclear_cache/aflush_cache/aget_cache_size all returned correct results; normalize_url edge cases (empty href, fragments, invalid scheme) all pass
- 使用的模型 token
- 314,304
- 测试的确切 commit
- e5d2e786d1a1
- 容器镜像
- sha256:cdd920bce783
没有测量什么
另一半内容,让你清楚看到这些证据能说明到什么程度。缺失的数据就标为缺失,从不填补。
- GPU 显存峰值
- 本次运行在 CPU 机器上进行,没有可采样的 GPU
- 长时间运行的表现
- 每次尝试都使用文档中最小的设置和固定的时间预算,因此这里测量的是它能否运行,而不是它在负载下的表现
观看会话
完整的运行过程,从一台干净的机器开始,按实际速度播放。没有剪辑,也没有加速。
第 1 次尝试的录屏,运行于 ,即决定上述结论的那次尝试。 制作该视频所用的终端录屏是证据,连同 sha256 指纹一起保存;视频只是由它渲染而成。 在你点击播放之前,不会从视频托管方加载任何内容。
录屏的结尾
决定该结论的终端会话的最后几行,与录制时完全一致。
- **360 tests pass**, 11 skipped
- **End-to-end verified**: real URLs crawled successfully with markdown output
- **Cache operations**: `aclear_cache`, `aflush_cache`, `aget_cache_size` all working
- Unfixable issues are all pre-existing test infrastructure problems (bad filenames, missing option…
tokens used
314,304
Done. The full report is in the JSON above. Key highlights:
- **8 bugs fixed** in `normalize_url`, `AsyncWebCrawler`, and `BaseDispatcher`
- **360 tests pass**, 11 skipped
- **End-to-end verified**: real URLs crawled successfully with markdown output
- **Cache operations**: `aclear_cache`, `aflush_cache`, `aget_cache_size` all working
- Unfixable issues are all pre-existing test infrastructure problems (bad filenames, missing option…
回放完整会话,从干净的机器到此刻的每一条命令。
测试方式
一个 agent,一个容器,没有人工协助。它按照项目自身文档所写的方式安装项目,运行它,并修复出错的地方。下面的一切都按实际发生的过程记录:终端会话、log 和确切的 commit。 完整方法论.
优势与局限
均为实测事实,而非观点。内容是如何撰写的.
顺利的部分
- 在干净的机器上达到了运行状态,会话有完整记录。
- 无需 GPU 即可运行,因此启动它并不需要 GPU。
- 采用 Apache-2.0 许可证,以其托管平台报告的信息为准。
- 已测量 2 次,因此结果并非偶然。
不顺利或尚不清楚的部分
- 安装用了 25 分钟,慢于 Argusic 测量过的 230 个同类项目的中位数。
- 搭建过程中遇到 14 个错误,其中 6 个没有解决。
在 Argusic 安装并计时过的 231 个 ai 项目中,crawl4ai 达到运行状态的速度排名第 205,231 个项目中有 152 个达到了运行状态。
适合用于
- 在笔记本电脑或小型服务器上试用:它无需 GPU 即达到了运行状态。
同一领域中也测试过的项目
这里的每个项目都由 Argusic 在干净的机器上安装并运行过。未经测试的项目不会出现在这里。
运行历史
主题 (来自 GitHub)
aiai-agentscrawl4ai-cloudcrawlerdata-extractionllmmarkdownmcpopen-sourceplaywrightpythonragscraperweb-crawlerweb-crawlingweb-scraping
嵌入徽章
用于项目 README 的 Markdown。徽章链接回本页;使用条款见 条款页面.
[](https://argusic.com/subject/crawl4ai)常见问题
- crawl4ai 能运行吗?
- 是的。crawl4ai 可以运行. Argusic 在一台干净的机器上安装并启动了它,用时 25 分钟,过程中遇到 14 个错误,并记录了整个会话。
- Argusic 是如何测试 crawl4ai 的?
- 在一台全新的一次性机器上进行,每条命令都被记录,仓库固定在 commit e5d2e786d1a1。共记录了 2 次尝试,完整方法见方法论页面。
- 测试 crawl4ai 花了多少钱?
- 得出该结论的那次运行花费 0.10 USD:这是真实的算力和模型成本,而不是按每百万 token 计的标价。该数字记录在那次运行的页面上。
- crawl4ai 安装需要多长时间?
- 在决定该结论的那次运行中,从干净的机器到运行状态用了 25 分钟。这是一次实测的尝试,不是平均值。
- crawl4ai 需要 GPU 吗?
- 启动它不需要。Argusic 在一台没有 GPU 的机器上让它达到了运行状态。
- 安装 crawl4ai 时会出现什么问题?
- 已记录的运行中出现了 14 个问题,其中 8 个在无人协助的情况下被修复。每个问题及其耗费的时间都列在本页上。
- crawl4ai 与其他替代方案相比如何?
- 在 Argusic 安装并计时过的 231 个 ai 项目中,crawl4ai 达到运行状态的速度排名第 205,231 个项目中有 152 个达到了运行状态。
- crawl4ai 的证据在哪里?
- 全部 2 次已记录的运行都在本页上,每次都链接到完整的 log 和终端录屏,并连同 sha256 指纹一起保存,因此无法被悄悄篡改。