Original em inglês: https://argusic.com/subject/assetopsbench
AssetOpsBench
AssetOpsBench - Indústria 4.0: um benchmark e framework unificados para construir, orquestrar e avaliar AI agents específicos de domínio para operações e manutenção de ativos da Indústria 4.0, com 460+ cenários, 5 agents especializados (IoT, FMSR, TSFM, Work Order,...) e modelos de orquestração multi-agent (MetaAgent, AgentHive) via MCP.
Executa com mocksfonte: GitHubPythonApache-2.0commit 81265cbbd36d
Python, licença Apache-2.0. O projeto se descreve como: ai for physical assets, condition based maintenance, hvac maintenance, iot, llm agents, model context protocol, predictive maintenance e time series forecasting.
AssetOpsBench executa, com substitutos para os serviços de que depende. Em uma máquina limpa sem GPU, um agent da Argusic o instalou em 20 minutos e encontrou 5 erros, corrigindo todos sem ajuda, e a sessão inteira foi gravada.
Project installs, builds, and 675 of 702 tests pass; 27 integration tests skip due to missing CouchDB/LLM credentials; all CLI entry points import and display help.
O que o agent conseguiu em uma máquina limpa, nas palavras dele. Como isto é medido
Medido pela Argusic em uma máquina nova, todas as vezes. Cada número tem link para as suas evidências. Pontuação Argusic 92 de 100 (a média das pontuações das execuções deste projeto).
Visão geral
Dados do projeto de GitHub, com link no topo desta página, atualizado em . Dados de teste da Argusic (CC BY 4.0); cada número tem link para uma página de execução com o log completo, a gravação e os hashes sha256 deles.
O que foi medido
Da execução que decidiu este veredito. Cada linha é um valor registrado, não uma estimativa.
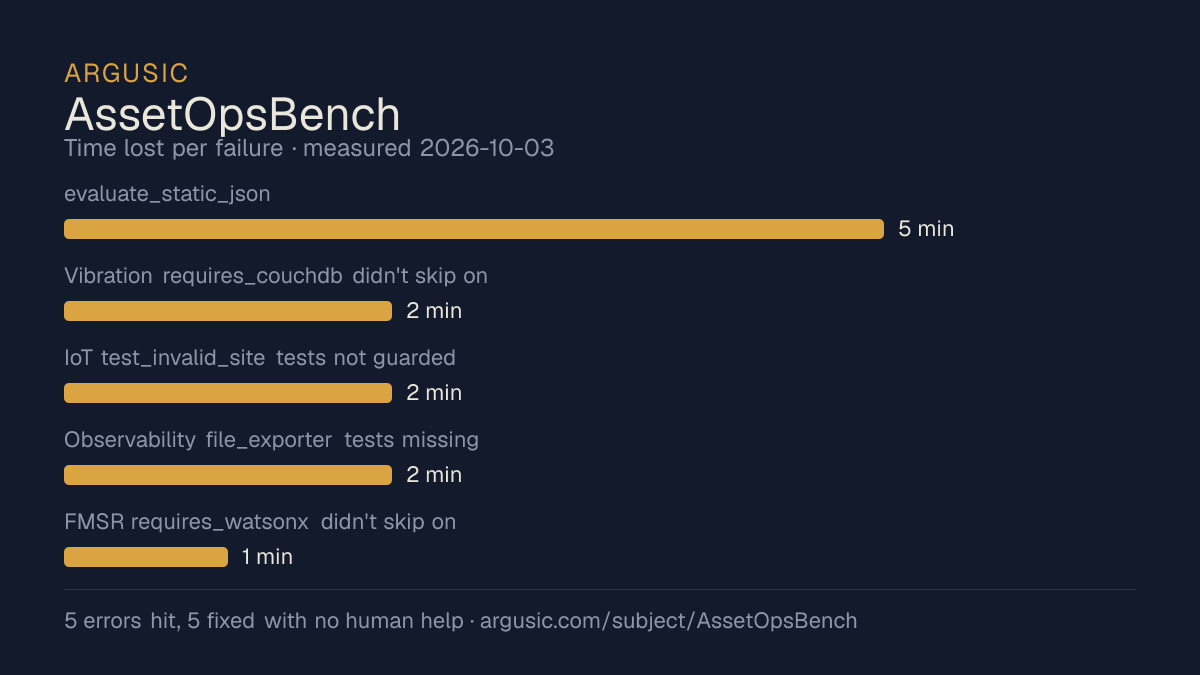
O que deu errado, nas palavras do agent
As palavras do próprio agent, das piores para as menores, nunca reescritas como conselho.
- evaluate_static_json() got unexpected keyword argument 'evaluation_metadata'5 minutos
- Vibration requires_couchdb didn't skip on unreachable CouchDB (empty-string env var)2 minutos
- IoT test_invalid_site tests not guarded against missing CouchDB2 minutos
- Observability file_exporter tests missing google.protobuf and opentelemetry-exporter2 minutos
- FMSR requires_watsonx didn't skip on empty-string WATSONX_APIKEY1 minuto
- Tempo de instalação
- 20 minutos
- Da máquina limpa até o fim
- 25 minutos
- Erros encontrados e corrigidos
- 5 encontrados, 5 corrigidos sem ajuda humana
- Como o resultado foi comprovado
- pytest src/ --tb=line -q exited 0, 675 passed, 27 skipped
- Tokens de modelo usados
- 129.831
- Commit exato testado
- 81265cbbd36d
- Imagem do container
- sha256:cdd920bce783
O que não foi medido
A outra metade, para você ver exatamente até onde estas evidências vão. Uma lacuna é mostrada como lacuna e nunca é preenchida.
- Pico de memória da GPU
- esta execução foi em uma máquina com CPU, então não havia GPU para medir
- Comportamento em uma execução longa
- cada tentativa usa as menores configurações documentadas e um orçamento de tempo fixo, então isto mede se ele executa, não como ele se comporta sob carga
- Comportamento com serviços reais
- esta execução foi verificada apenas com serviços substitutos
O fim da gravação
As últimas linhas da sessão de terminal que decidiu este veredito, exatamente como foram gravadas.
tokens used
129,831
**Final summary of what was done:**
1. **`uv sync`** completed successfully — all dependencies installed, `.venv` created with Python 3…
2. **Fixed test failures:**
   - **`static_json_scorer.py`** — Added `evaluation_metadata` parameter to `evaluate_static_json()…
   - **`vibration/tests/conftest.py`** — `requires_couchdb` marker now actually checks reachability…
   - **`fmsr/tests/conftest.py`** — `requires_watsonx` marker now uses truthiness instead of `is No…
   - **`iot/tests/test_tools.py`** — Added `@requires_couchdb` to 11 `test_invalid_site` methods th…
3. **Installed missing runtime deps:** `protobuf` and `opentelemetry-exporter-otlp-proto-http` for …
4. **Final test suite:** 675 passed, 27 skipped, 0 failed (27 skipped are CouchDB/LLM integration t…
5. **CLI entry points** all import correctly, `--help` commands work.
Reproduzir a sessão inteira, cada comando desde a máquina limpa até este ponto.
Como foi testado
Um agent, um container, nenhuma ajuda humana. Ele instala o projeto do jeito que a própria documentação do projeto manda, executa o projeto e corrige o que quebra. Tudo abaixo é registrado como aconteceu: a sessão de terminal, o log e o commit exato. A metodologia completa.
Pontos fortes e limites
Fatos medidos, não opiniões. Como este conteúdo é escrito.
O que deu certo
- Instalado em 20 minutos.
- Recuperou-se de todos os 5 erros sem que uma pessoa interviesse, o que indica que as falhas estão documentadas o suficiente para serem resolvidas.
- Licença Apache-2.0, segundo a plataforma onde o projeto está hospedado.
O que não deu certo, ou não se sabe
- Só chegou a um estado de execução com serviços substitutos, então nada aqui prova que ele funciona com os serviços reais.
- Medido uma vez até agora. Uma única tentativa mostra que ele pode executar, não que executa de forma confiável.
Também testados, na mesma área
Cada um destes foi instalado e executado pela Argusic em uma máquina limpa. Nada aparece aqui sem ter sido testado.
Histórico de execuções
| testado por | tentativa | resultado | pontuação | custo USD | quando |
|---|---|---|---|---|---|
| Argusic Runner | 1/3 | Executa com mocks | 92,00 | 0,25 |
Tópicos (de GitHub)
ai-for-physical-assetscondition-based-maintenancehvac-maintenanceiotllm-agentsmodel-context-protocolpredictive-maintenancetime-series-forecasting
Incorporar o selo
Markdown para o README do projeto. Ele tem link de volta para esta página; os termos estão na página de termos.
[](https://argusic.com/subject/assetopsbench)Perguntas
- AssetOpsBench executa?
- AssetOpsBench executa, com mocks no lugar de serviços externos. A Argusic o instalou e iniciou em uma máquina limpa em 20 minutos, encontrando 5 erros no caminho, e gravou a sessão.
- Como a Argusic testou AssetOpsBench?
- Em uma máquina nova e descartável, com cada comando gravado e o repositório fixado no commit 81265cbbd36d. Há uma tentativa registrada, e a metodologia completa está na página da metodologia.
- Quanto custou testar AssetOpsBench?
- A execução que produziu este veredito custou US$ 0,25: custo real de computação e de modelo, não um preço de tabela por milhão de tokens. Esse valor está registrado na página da execução.
- Quanto tempo leva para instalar AssetOpsBench?
- 20 minutos na execução que decidiu este veredito, de uma máquina limpa até um estado de execução. É uma tentativa medida, não uma média.
- AssetOpsBench precisa de GPU?
- Não para iniciar. A Argusic chegou a um estado de execução em uma máquina sem GPU.
- O que dá errado ao instalar AssetOpsBench?
- 5 coisas quebraram na execução registrada, e 5 foram corrigidas sem ajuda humana. Cada uma, com o tempo que custou, está listada nesta página.
- Onde estão as evidências de AssetOpsBench?
- A execução registrada está nesta página, cada uma com link para o seu log completo e a sua gravação do terminal, guardados com uma impressão digital sha256 para que não possam ser alterados discretamente.