Original en inglés: https://argusic.com/subject/crawly
crawly
Crawly, a high-level web crawling & scraping framework for Elixir.
Funcionafuente: GitHubElixirApache-2.0commit e27f032285bd
Elixir, licencia Apache-2.0. El proyecto se describe a sí mismo como: crawler, crawling, elixir, erlang, extract data, scraper, scraping y scraping websites.
crawly funciona. Un agent de Argusic lo instaló en 11 minutos y encontró 4 errores, todos corregidos sin ayuda en una máquina limpia sin GPU, y toda la sesión quedó grabada.
Crawly 0.17.2 Elixir library compiles, starts its Cowboy HTTP API on port 4001 answering 200, and runs its 136-test suite with 0 failures and 1 excluded test
Lo que el agent consiguió en una máquina limpia, en sus propias palabras. Cómo se mide
Medido por Argusic en una máquina limpia cada vez. Cada cifra enlaza a su evidencia. Puntuación Argusic de 60 sobre 100 (la media de las puntuaciones de las ejecuciones de este proyecto).
De un vistazo
Datos del proyecto de GitHub, enlazados al principio de esta página. Datos de prueba de Argusic (CC BY 4.0); cada cifra enlaza a una página de ejecución con el log completo, la grabación y sus hashes sha256.
Qué se midió
De la ejecución que decidió este veredicto. Cada línea es un valor registrado, no una estimación.
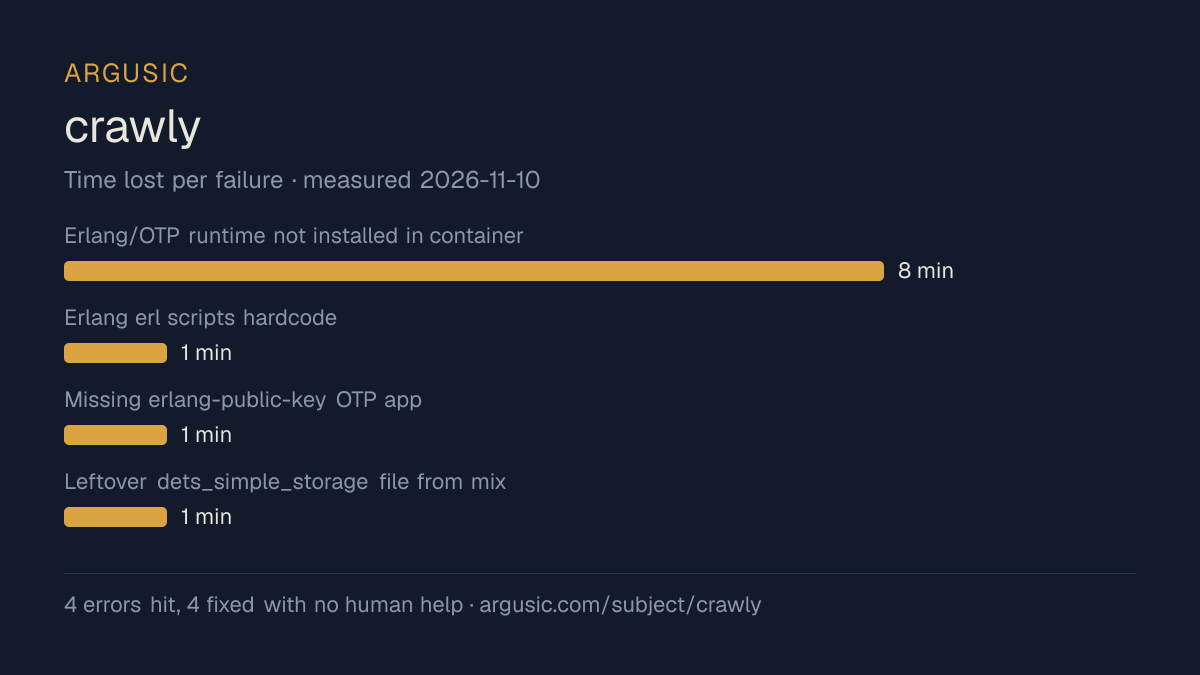
Qué salió mal, en palabras del propio agent
Las palabras del propio agent, de lo más grave a lo menos, nunca reescritas como consejos.
- Erlang/OTP runtime not installed in container (no erl, erlc, escript binaries)8 minutos
- Erlang erl scripts hardcode ROOTDIR=/usr/lib/erlang which doesn't exist in container1 minuto
- Missing erlang-public-key OTP app (public_key.app, BEAM files)1 minuto
- Leftover dets_simple_storage file from mix run pollutes test state causing failures on re-runs1 minuto
- Tiempo de instalación
- 11 minutos
- De máquina en frío a terminar
- 11 minutos
- Errores encontrados y corregidos
- 4 encontrados, 4 corregidos sin ayuda humana
- Cómo se demostró el resultado
- mix test exited 0, 136 tests passed, 0 failures, 1 excluded; curl -s -o /dev/null -w '%{http_code}' http://localhost:4001/ returned 200; mix run --no-halt -e 'IO.puts("...")' booted without error
- Tokens de modelo usados
- 281.441
- Commit exacto probado
- e27f032285bd
- Imagen del contenedor
- sha256:cdd920bce783
Qué no se midió
La otra mitad, para que veas exactamente hasta dónde llega esta evidencia. Un hueco se muestra como hueco y nunca se rellena.
- Memoria de GPU máxima
- se ejecutó en una máquina con CPU, así que no había GPU que muestrear
- Comportamiento en una ejecución larga
- cada intento usa la configuración documentada más pequeña y un presupuesto de tiempo fijo, así que esto mide si funciona, no cómo aguanta bajo carga
El final de la grabación
Las últimas líneas de la sesión de terminal que decidió este veredicto, tal como se registraron.
Now let me provide the final result.
tokens used
281,441
The HTTP API returns 200 on port 4001. The app works end to end.
Let me compile my final report. Let me calculate the elapsed time.
The process started at approximately 08:11 when the first command ran, and now is 08:22. So about 1…
Let me also note the errors I hit and how I fixed them:
1. **Missing Erlang runtime** - The container had Elixir .tool-versions but no actual Erlang/Elixir…
2. **Hardcoded ROOTDIR** in erl scripts - The Ubuntu erl scripts hardcode `/usr/lib/erlang`. Fixed …
3. **Missing public_key** OTP app - The erlang-public-key is a separate deb package in Ubuntu. Fixe…
4. **DETS state file** - Leftover `dets_simple_storage` from a `mix run` would pollute subsequent t…
Now let me provide the final result.
Reproducir la sesión completa, cada comando desde una máquina limpia hasta este punto.
Cómo se probó
Un agent, un contenedor, sin ayuda humana. Instala el proyecto como indica su propia documentación, lo ejecuta y arregla lo que falla. Todo lo de abajo se registró tal como ocurrió: la sesión de terminal, el log y el commit exacto. La metodología completa.
Puntos fuertes y límites
Hechos medidos, no opiniones. Cómo se redacta.
Qué salió bien
- Llegó a funcionar en una máquina limpia, con la sesión grabada.
- Se recuperó de los 4 errores sin que interviniera una persona, lo que indica que los fallos están lo bastante documentados como para resolverlos.
- Funcionó sin GPU, así que no necesita una para arrancar.
- Licencia Apache-2.0, según su plataforma de origen.
- Medido 2 veces, así que el resultado no es algo puntual.
Qué no salió bien, o no se sabe
- Tardó 11 minutos en instalarse, más lento que la mediana de los 25 proyectos comparables que ha medido Argusic.
De los 26 proyectos de crawler que Argusic ha instalado y cronometrado, crawly fue el 18.º más rápido en llegar a funcionar, y 20 de 26 llegaron a funcionar.
Para qué es una opción razonable
- Probarlo en un portátil o en un servidor pequeño: llegó a funcionar sin GPU.
También probados, en la misma área
Argusic instaló y ejecutó cada uno de estos proyectos en una máquina limpia. Aquí no aparece nada que no se haya probado.
Historial de ejecuciones
| probado por | intento | resultado | puntuación | costo USD | cuándo |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Funciona | 100,00 | 0,12 | |
| Argusic Runner | 1/3 | No funcionó | 20,00 | 0,00 |
Temas (de GitHub)
crawlercrawlingelixirerlangextract-datascraperscrapingscraping-websitesspider
Insertar el badge
Markdown para el README del proyecto. Enlaza de vuelta aquí; condiciones en la página de términos.
[](https://argusic.com/subject/crawly)Preguntas
- ¿Funciona crawly?
- Sí. crawly funciona. Argusic lo instaló y lo inició en una máquina limpia en 11 minutos, con 4 errores por el camino, y grabó la sesión.
- ¿Cómo probó Argusic crawly?
- En una máquina limpia y desechable, con cada comando grabado y el repositorio fijado en el commit e27f032285bd. Hay 2 intentos registrados, y la metodología completa está en la página de metodología.
- ¿Cuánto costó probar crawly?
- La ejecución que produjo este veredicto costó 0,12 USD: costo real de cómputo y de modelo, no un precio de lista por millón de tokens. Consta en la página de esa ejecución.
- ¿Cuánto tarda crawly en instalarse?
- 11 minutos en la ejecución que decidió este veredicto, desde una máquina limpia hasta que funcionó. Es un intento medido, no una media.
- ¿Necesita crawly una GPU?
- No para arrancar. Argusic consiguió que funcionara en una máquina sin GPU.
- ¿Qué falla al instalar crawly?
- En la ejecución registrada fallaron 4 cosas, y 4 se corrigieron sin ayuda humana. Cada una, con el tiempo que costó, aparece en esta página.
- ¿Cómo se compara crawly con las alternativas?
- De los 26 proyectos de crawler que Argusic ha instalado y cronometrado, crawly fue el 18.º más rápido en llegar a funcionar, y 20 de 26 llegaron a funcionar.
- ¿Dónde está la evidencia de crawly?
- Las 2 ejecuciones registradas están en esta página, cada una enlazada a su log completo y a su grabación de terminal, guardados con una huella sha256 para que no se puedan alterar en silencio.