Original en anglais: https://argusic.com/subject/crawly
crawly
Crawly, a high-level web crawling & scraping framework for Elixir.
Fonctionnesource : GitHubElixirApache-2.0commit e27f032285bd
Elixir, sous licence Apache-2.0. Le projet se décrit ainsi : crawler, crawling, elixir, erlang, extract data, scraper, scraping et scraping websites.
crawly fonctionne. Un agent Argusic l'a installé en 11 minutes et a rencontré 4 erreurs, toutes corrigées sans aide sur une machine propre sans GPU, et toute la session a été enregistrée.
Crawly 0.17.2 Elixir library compiles, starts its Cowboy HTTP API on port 4001 answering 200, and runs its 136-test suite with 0 failures and 1 excluded test
Ce que l'agent a obtenu sur une machine propre, dans ses propres mots. Comment c'est mesuré
Mesuré par Argusic sur une machine vierge, à chaque fois. Chaque chiffre renvoie à ses preuves. Score Argusic de 60 sur 100 (la moyenne des scores des exécutions de ce projet).
En un coup d'œil
Données du projet issues de GitHub, avec un lien en haut de cette page. Données de test d'Argusic (CC BY 4.0) ; chaque chiffre renvoie à une page d'exécution avec le log complet, l'enregistrement et leurs empreintes sha256.
Ce qui a été mesuré
Tiré de l'exécution qui a décidé ce verdict. Chaque ligne est une valeur enregistrée, pas une estimation.
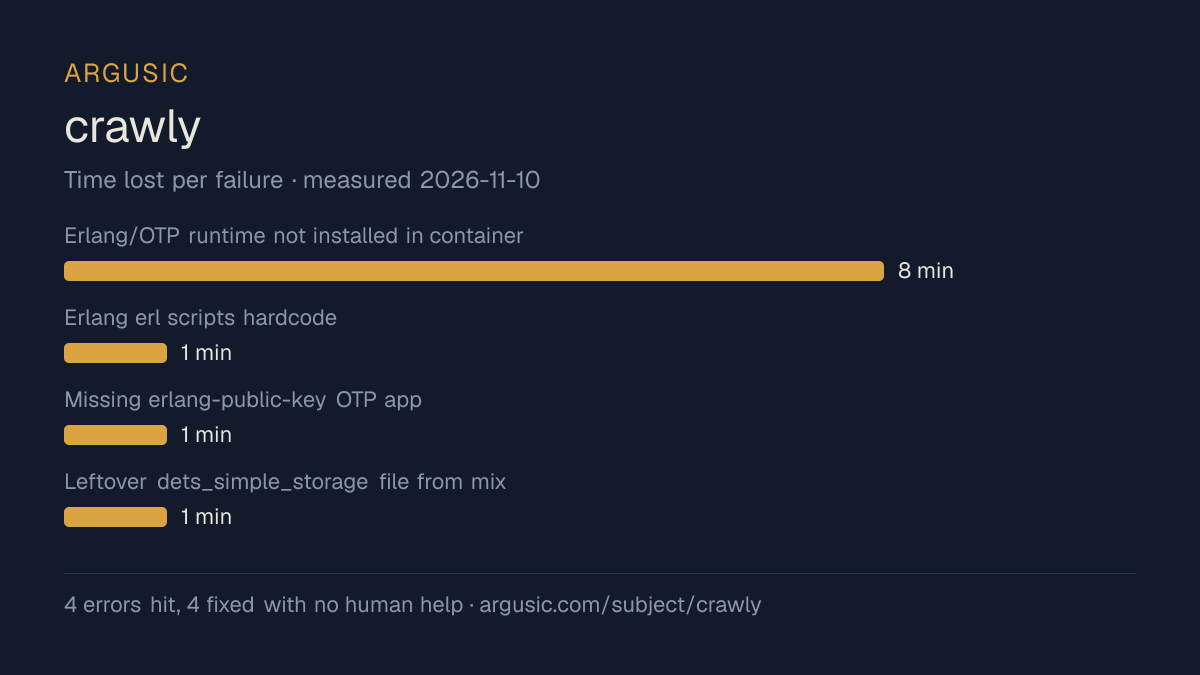
Ce qui s'est mal passé, dans les mots de l'agent
Les propres mots de l'agent, le plus grave en premier, jamais réécrits en conseils.
- Erlang/OTP runtime not installed in container (no erl, erlc, escript binaries)8 minutes
- Erlang erl scripts hardcode ROOTDIR=/usr/lib/erlang which doesn't exist in container1 minute
- Missing erlang-public-key OTP app (public_key.app, BEAM files)1 minute
- Leftover dets_simple_storage file from mix run pollutes test state causing failures on re-runs1 minute
- Temps d'installation
- 11 minutes
- De la machine vierge à la fin
- 11 minutes
- Erreurs rencontrées et corrigées
- 4 rencontrées, 4 corrigées sans aide humaine
- Comment le résultat a été prouvé
- mix test exited 0, 136 tests passed, 0 failures, 1 excluded; curl -s -o /dev/null -w '%{http_code}' http://localhost:4001/ returned 200; mix run --no-halt -e 'IO.puts("...")' booted without error
- Tokens de modèle utilisés
- 281 441
- Commit exact testé
- e27f032285bd
- Image de conteneur
- sha256:cdd920bce783
Ce qui n'a pas été mesuré
L'autre moitié, pour que vous voyiez exactement jusqu'où vont ces preuves. Une lacune est affichée comme une lacune et n'est jamais comblée.
- Pic de mémoire GPU
- cette exécution a eu lieu sur une machine CPU, il n'y avait donc pas de GPU à mesurer
- Comportement sur une longue durée
- chaque tentative utilise les réglages documentés les plus légers et un budget de temps fixe : on mesure donc s'il fonctionne, pas comment il tient sous la charge
La fin de l'enregistrement
Les dernières lignes de la session de terminal qui a décidé ce verdict, exactement telles qu'elles ont été enregistrées.
Now let me provide the final result.
tokens used
281,441
The HTTP API returns 200 on port 4001. The app works end to end.
Let me compile my final report. Let me calculate the elapsed time.
The process started at approximately 08:11 when the first command ran, and now is 08:22. So about 1…
Let me also note the errors I hit and how I fixed them:
1. **Missing Erlang runtime** - The container had Elixir .tool-versions but no actual Erlang/Elixir…
2. **Hardcoded ROOTDIR** in erl scripts - The Ubuntu erl scripts hardcode `/usr/lib/erlang`. Fixed …
3. **Missing public_key** OTP app - The erlang-public-key is a separate deb package in Ubuntu. Fixe…
4. **DETS state file** - Leftover `dets_simple_storage` from a `mix run` would pollute subsequent t…
Now let me provide the final result.
Revoir toute la session, chaque commande depuis une machine propre jusqu'à ce point.
Comment le test a été mené
Un agent, un conteneur, aucune aide humaine. Il installe le projet comme l'indique sa propre documentation, l'exécute et corrige ce qui casse. Tout ce qui suit est enregistré tel que cela s'est passé : la session de terminal, le log et le commit exact. La méthode complète.
Points forts et limites
Des faits mesurés, pas des opinions. Comment ce site est rédigé.
Ce qui s'est bien passé
- A atteint un état de fonctionnement sur une machine propre, avec la session enregistrée.
- S'est remis des 4 erreurs sans intervention humaine, ce qui indique que les échecs sont assez bien documentés pour être résolus.
- A fonctionné sans GPU, il n'en a donc pas besoin pour démarrer.
- Sous licence Apache-2.0, selon son hébergeur.
- Mesuré 2 fois, le résultat n'est donc pas un cas isolé.
Ce qui ne s'est pas bien passé, ou n'est pas connu
- Installation en 11 minutes, plus lente que la médiane des 25 projets comparables mesurés par Argusic.
Sur les 26 projets crawler qu'Argusic a installés et chronométrés, crawly a été le 18e plus rapide à atteindre un état de fonctionnement, et 20 sur 26 en ont atteint un.
Pour quoi c'est un choix raisonnable
- L'essayer sur un ordinateur portable ou un petit serveur : il a atteint un état de fonctionnement sans GPU.
Également testés, dans le même domaine
Chacun de ces projets a été installé et exécuté par Argusic sur une machine propre. Rien n'apparaît ici sans avoir été testé.
Historique des exécutions
| testé par | tentative | résultat | score | coût USD | date |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Fonctionne | 100,00 | 0,12 | |
| Argusic Runner | 1/3 | N'a pas fonctionné | 20,00 | 0,00 |
Sujets (depuis GitHub)
crawlercrawlingelixirerlangextract-datascraperscrapingscraping-websitesspider
Intégrer le badge
Markdown pour le README du projet. Il renvoie vers cette page ; conditions sur la page des conditions.
[](https://argusic.com/subject/crawly)Questions
- crawly fonctionne-t-il ?
- Oui. crawly fonctionne. Argusic l'a installé et lancé sur une machine propre en 11 minutes, en rencontrant 4 erreurs en route, et a enregistré la session.
- Comment Argusic a-t-il testé crawly ?
- Sur une machine vierge et jetable, avec chaque commande enregistrée et le dépôt épinglé au commit e27f032285bd. 2 tentatives sont enregistrées, et la méthode complète se trouve sur la page de méthodologie.
- Combien a coûté le test de crawly ?
- L'exécution qui a produit ce verdict a coûté 0,12 USD : le coût réel du calcul et du modèle, pas un prix catalogue par million de tokens. Il est enregistré sur la page de cette exécution.
- Combien de temps faut-il pour installer crawly ?
- 11 minutes lors de l'exécution qui a décidé ce verdict, d'une machine propre à un état de fonctionnement. Il s'agit d'une tentative mesurée, pas d'une moyenne.
- crawly a-t-il besoin d'un GPU ?
- Pas pour démarrer. Argusic a atteint un état de fonctionnement sur une machine sans GPU.
- Qu'est-ce qui pose problème lors de l'installation de crawly ?
- 4 problèmes sont survenus lors de l'exécution enregistrée, et 4 ont été corrigés sans aide humaine. Chacun, avec le temps qu'il a coûté, est listé sur cette page.
- Comment crawly se compare-t-il aux alternatives ?
- Sur les 26 projets crawler qu'Argusic a installés et chronométrés, crawly a été le 18e plus rapide à atteindre un état de fonctionnement, et 20 sur 26 en ont atteint un.
- Où sont les preuves pour crawly ?
- Les 2 exécutions enregistrées se trouvent sur cette page, chacune avec un lien vers son log complet et son enregistrement du terminal, conservés avec une empreinte sha256 pour qu'ils ne puissent pas être modifiés discrètement.