Original em inglês: https://argusic.com/subject/crawly
crawly
Crawly, a high-level web crawling & scraping framework for Elixir.
Executafonte: GitHubElixirApache-2.0commit e27f032285bd
Elixir, licença Apache-2.0. O projeto se descreve como: crawler, crawling, elixir, erlang, extract data, scraper, scraping e scraping websites.
crawly executa. Em uma máquina limpa sem GPU, um agent da Argusic o instalou em 11 minutos e encontrou 4 erros, corrigindo todos sem ajuda, e a sessão inteira foi gravada.
Crawly 0.17.2 Elixir library compiles, starts its Cowboy HTTP API on port 4001 answering 200, and runs its 136-test suite with 0 failures and 1 excluded test
O que o agent conseguiu em uma máquina limpa, nas palavras dele. Como isto é medido
Medido pela Argusic em uma máquina nova, todas as vezes. Cada número tem link para as suas evidências. Pontuação Argusic 60 de 100 (a média das pontuações das execuções deste projeto).
Visão geral
Dados do projeto de GitHub, com link no topo desta página. Dados de teste da Argusic (CC BY 4.0); cada número tem link para uma página de execução com o log completo, a gravação e os hashes sha256 deles.
O que foi medido
Da execução que decidiu este veredito. Cada linha é um valor registrado, não uma estimativa.
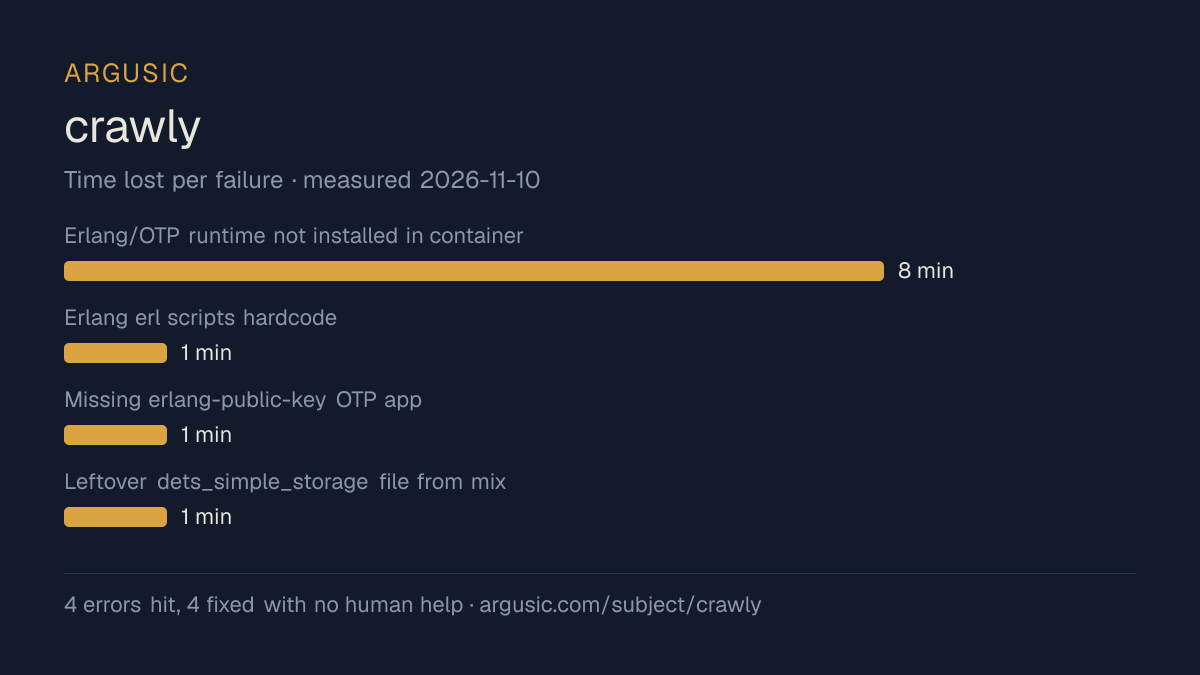
O que deu errado, nas palavras do agent
As palavras do próprio agent, das piores para as menores, nunca reescritas como conselho.
- Erlang/OTP runtime not installed in container (no erl, erlc, escript binaries)8 minutos
- Erlang erl scripts hardcode ROOTDIR=/usr/lib/erlang which doesn't exist in container1 minuto
- Missing erlang-public-key OTP app (public_key.app, BEAM files)1 minuto
- Leftover dets_simple_storage file from mix run pollutes test state causing failures on re-runs1 minuto
- Tempo de instalação
- 11 minutos
- Da máquina limpa até o fim
- 11 minutos
- Erros encontrados e corrigidos
- 4 encontrados, 4 corrigidos sem ajuda humana
- Como o resultado foi comprovado
- mix test exited 0, 136 tests passed, 0 failures, 1 excluded; curl -s -o /dev/null -w '%{http_code}' http://localhost:4001/ returned 200; mix run --no-halt -e 'IO.puts("...")' booted without error
- Tokens de modelo usados
- 281.441
- Commit exato testado
- e27f032285bd
- Imagem do container
- sha256:cdd920bce783
O que não foi medido
A outra metade, para você ver exatamente até onde estas evidências vão. Uma lacuna é mostrada como lacuna e nunca é preenchida.
- Pico de memória da GPU
- esta execução foi em uma máquina com CPU, então não havia GPU para medir
- Comportamento em uma execução longa
- cada tentativa usa as menores configurações documentadas e um orçamento de tempo fixo, então isto mede se ele executa, não como ele se comporta sob carga
O fim da gravação
As últimas linhas da sessão de terminal que decidiu este veredito, exatamente como foram gravadas.
Now let me provide the final result.
tokens used
281,441
The HTTP API returns 200 on port 4001. The app works end to end.
Let me compile my final report. Let me calculate the elapsed time.
The process started at approximately 08:11 when the first command ran, and now is 08:22. So about 1…
Let me also note the errors I hit and how I fixed them:
1. **Missing Erlang runtime** - The container had Elixir .tool-versions but no actual Erlang/Elixir…
2. **Hardcoded ROOTDIR** in erl scripts - The Ubuntu erl scripts hardcode `/usr/lib/erlang`. Fixed …
3. **Missing public_key** OTP app - The erlang-public-key is a separate deb package in Ubuntu. Fixe…
4. **DETS state file** - Leftover `dets_simple_storage` from a `mix run` would pollute subsequent t…
Now let me provide the final result.
Reproduzir a sessão inteira, cada comando desde a máquina limpa até este ponto.
Como foi testado
Um agent, um container, nenhuma ajuda humana. Ele instala o projeto do jeito que a própria documentação do projeto manda, executa o projeto e corrige o que quebra. Tudo abaixo é registrado como aconteceu: a sessão de terminal, o log e o commit exato. A metodologia completa.
Pontos fortes e limites
Fatos medidos, não opiniões. Como este conteúdo é escrito.
O que deu certo
- Chegou a um estado de execução em uma máquina limpa, com a sessão gravada.
- Recuperou-se de todos os 4 erros sem que uma pessoa interviesse, o que indica que as falhas estão documentadas o suficiente para serem resolvidas.
- Executou sem GPU, então não precisa de uma para iniciar.
- Licença Apache-2.0, segundo a plataforma onde o projeto está hospedado.
- Medido 2 vezes, então o resultado não é um caso isolado.
O que não deu certo, ou não se sabe
- Levou 11 minutos para instalar, mais devagar que a mediana dos 25 projetos comparáveis que a Argusic mediu.
Dos 26 projetos de crawler que a Argusic instalou e cronometrou, crawly foi o 18º mais rápido a chegar a um estado de execução, e 20 de 26 chegaram a esse estado.
Para que é uma escolha razoável
- Testar em um laptop ou em um servidor pequeno: ele chegou a um estado de execução sem GPU.
Também testados, na mesma área
Cada um destes foi instalado e executado pela Argusic em uma máquina limpa. Nada aparece aqui sem ter sido testado.
Histórico de execuções
| testado por | tentativa | resultado | pontuação | custo USD | quando |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Executa | 100,00 | 0,12 | |
| Argusic Runner | 1/3 | Não executou | 20,00 | 0,00 |
Tópicos (de GitHub)
crawlercrawlingelixirerlangextract-datascraperscrapingscraping-websitesspider
Incorporar o selo
Markdown para o README do projeto. Ele tem link de volta para esta página; os termos estão na página de termos.
[](https://argusic.com/subject/crawly)Perguntas
- crawly executa?
- Sim. crawly executa. A Argusic o instalou e iniciou em uma máquina limpa em 11 minutos, encontrando 4 erros no caminho, e gravou a sessão.
- Como a Argusic testou crawly?
- Em uma máquina nova e descartável, com cada comando gravado e o repositório fixado no commit e27f032285bd. Há 2 tentativas registradas, e a metodologia completa está na página da metodologia.
- Quanto custou testar crawly?
- A execução que produziu este veredito custou US$ 0,12: custo real de computação e de modelo, não um preço de tabela por milhão de tokens. Esse valor está registrado na página da execução.
- Quanto tempo leva para instalar crawly?
- 11 minutos na execução que decidiu este veredito, de uma máquina limpa até um estado de execução. É uma tentativa medida, não uma média.
- crawly precisa de GPU?
- Não para iniciar. A Argusic chegou a um estado de execução em uma máquina sem GPU.
- O que dá errado ao instalar crawly?
- 4 coisas quebraram na execução registrada, e 4 foram corrigidas sem ajuda humana. Cada uma, com o tempo que custou, está listada nesta página.
- Como crawly se compara às alternativas?
- Dos 26 projetos de crawler que a Argusic instalou e cronometrou, crawly foi o 18º mais rápido a chegar a um estado de execução, e 20 de 26 chegaram a esse estado.
- Onde estão as evidências de crawly?
- Todas as 2 execuções registradas estão nesta página, cada uma com link para o seu log completo e a sua gravação do terminal, guardados com uma impressão digital sha256 para que não possam ser alterados discretamente.