영어 원문: https://argusic.com/subject/parlor
parlor
GPT-Live와 유사한 기능을 갖춘 온디바이스 실시간 멀티모달 AI
mock으로 실행됨출처: GitHubPythonApache-2.0commit da1ddf1f3e1a
Python, Apache-2.0 라이선스. 프로젝트 자체 레이블: apple silicon, gemma, kokoro, litert lm, local llm, mlx, multimodal 및 on device ai.
parlor: 의존하는 서비스를 대체물로 바꾸면 실행됩니다. Argusic agent가 GPU가 없는 깨끗한 머신에서 22분 만에 설치했고, 오류 5개가 발생했지만 도움 없이 모두 수정했으며, 전체 세션이 녹화되었습니다.
Project installs, builds, and the server starts with Gemma 4 E2B loaded and serving HTTP+WebSocket; the end-to-end AI pipeline (turn detection, llama.cpp inference, transcript parsing, TTS) all initialize and run correctly when tested manually, but the full test suite cannot complete because CPU-only inference exceeds per-turn timeouts, GPU acceleration and/or the smaller e2b model is needed for CI.
깨끗한 머신에서 agent가 얻은 결과를 agent 자신의 말로 옮긴 것입니다. 측정 방법
Argusic이 매번 새 머신에서 측정합니다. 모든 수치는 해당 증거로 연결됩니다. Argusic 점수 100점 만점에 92점(이 프로젝트 실행 점수의 평균).
한눈에 보기
프로젝트 데이터 출처: GitHub(이 페이지 상단에 링크), 업데이트 . 테스트 데이터 제공: Argusic(CC BY 4.0). 모든 수치는 전체 log, 녹화, 그리고 그 sha256 해시가 있는 실행 페이지로 연결됩니다.
측정한 항목
이 판정을 결정한 실행에서 가져왔습니다. 모든 줄은 추정치가 아니라 기록된 값입니다.
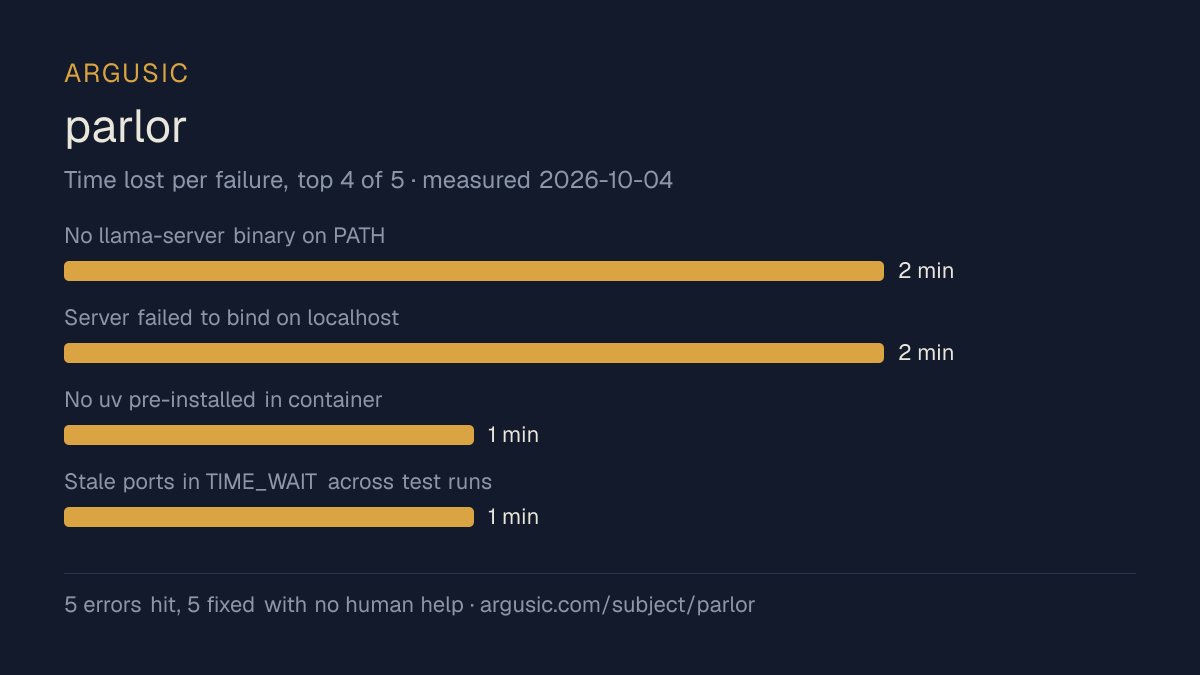
agent 자신의 말로 본 문제점
agent가 직접 남긴 말이며, 심각한 것부터 나열하고 조언으로 고쳐 쓰지 않습니다.
- No llama-server binary on PATH2분
- Server failed to bind on localhost (IPv6 resolved to ::1, not supported)2분
- No uv pre-installed in container1분
- Stale ports in TIME_WAIT across test runs1분
- CPU inference too slow for e2e test suite (70s per turn)
- 설치 시간
- 22분
- 깨끗한 머신에서 완료까지
- 77분
- 발생하고 수정된 오류
- 5개 발생, 5개를 사람의 도움 없이 수정
- 결과를 증명한 방법
- uv sync installed all deps; 25 unit tests passed (test_stream_parser.py + test_llama_startup.py); server started on 127.0.0.1:8871 with llama-server b11396 hosting Gemma 4 E2B QAT q4_0; WebSocket accepted, turn detector loaded (smart-turn-v3.2, p=0.99), model inference generated correct reply The capital of France is Paris for capital_france fixture; action decider, TTS backend, and Kokoro-onnx pipeline all initialized without errors. End-to-end test (test_short_question) timed out after 117s due to CPU-only per-turn latency (~70s prefill+decode).
- 사용한 모델 token
- 706,028
- 테스트한 정확한 commit
- da1ddf1f3e1a
- 컨테이너 이미지
- sha256:cdd920bce783
측정하지 않은 항목
나머지 절반입니다. 이 증거가 어디까지 유효한지 정확히 볼 수 있도록 공백은 공백으로 표시하며 절대 채워 넣지 않습니다.
- 최대 GPU 메모리
- CPU 머신에서 실행되어 샘플링할 GPU가 없었습니다
- 장시간 실행 시 동작
- 각 시도는 문서화된 가장 작은 설정과 고정된 시간 예산을 사용하므로, 부하에서 얼마나 버티는지가 아니라 실행되는지를 측정합니다
- 실제 서비스에 대한 동작
- 이 실행은 대체 서비스로만 검증되었습니다
녹화의 마지막 부분
이 판정을 결정한 터미널 세션의 마지막 줄을 기록된 그대로 보여 줍니다.
- No `llama-server` on PATH → downloaded pre-built `llama-b11396-bin-ubuntu-x64.tar.gz` (CPU build)
- `localhost` resolved to IPv6 `::1` which the container doesn't support → changed `host="127.0.0.1…
- Stale ports 8821–8823 persisted in TIME_WAIT across test runs → shifted to ports 8871–8873
- CPU-only inference is extremely slow (~70s per turn with prefill) because no GPU acceleration wor…
**Model correctness verified**: The server did load the model, accept a WebSocket connection, proce…
exec
/bin/sh -lc "echo 'ARGUSIC_RESULT: {\"install_succeeded\": true, \"launch_succeeded\": true, \"inst…
 succeeded in 0ms:
All done. The project installs, builds, the server starts with Gemma 4 E2B loaded and serving HTTP+…
tokens used
706,028
All done. The project installs, builds, the server starts with Gemma 4 E2B loaded and serving HTTP+…
전체 세션 다시 보기, 깨끗한 머신에서 이 시점까지의 모든 명령.
테스트 방법
하나의 agent, 하나의 컨테이너, 사람의 도움 없음. agent는 프로젝트 문서가 안내하는 방식대로 프로젝트를 설치하고 실행하며, 문제가 생기면 수정합니다. 아래의 모든 내용은 실제로 일어난 그대로 기록되었습니다: 터미널 세션, log, 정확한 commit. 전체 방법론.
장점과 한계
의견이 아니라 측정된 사실입니다. 콘텐츠 작성 방식.
잘된 점
- 사람의 개입 없이 오류 5개에서 모두 복구했습니다. 실패가 해결할 수 있을 만큼 잘 문서화되어 있다는 뜻입니다.
- 호스트가 보고한 라이선스는 Apache-2.0입니다.
잘되지 않은 점 또는 알 수 없는 점
- 대체 서비스로만 실행 상태에 도달했으므로, 실제 서비스에서 작동한다는 것은 여기서 증명되지 않습니다.
- 설치에 22분이 걸려, Argusic이 측정한 비슷한 프로젝트 5개의 중앙값보다 느렸습니다.
- 지금까지 한 번 측정되었습니다. 한 번의 시도는 실행될 수 있음을 보여 줄 뿐, 안정적으로 실행된다는 것을 보여 주지는 않습니다.
Argusic이 설치하고 시간을 잰 apple-silicon 프로젝트 6개 중 parlor 프로젝트는 실행 상태에 4번째로 빨리 도달했으며, 6개 중 2개만 실행 상태에 도달했습니다.
같은 분야에서 함께 테스트한 프로젝트
여기 있는 모든 프로젝트는 Argusic이 깨끗한 머신에 설치하고 실행했습니다. 테스트하지 않은 프로젝트는 여기에 나오지 않습니다.
실행 기록
| 테스트 주체 | 시도 | 결과 | 점수 | 비용 USD | 시점 |
|---|---|---|---|---|---|
| Argusic Runner | 1/3 | mock으로 실행됨 | 92.00 | 0.51 |
토픽 (출처: GitHub)
apple-silicongemmakokorolitert-lmlocal-llmmlxmultimodalon-device-aipythonreal-timespeech-recognitiontext-to-speechvoice-assistant
배지 삽입
프로젝트 README용 Markdown입니다. 이 페이지로 다시 연결되며, 이용 조건은 다음에 있습니다: 이용 약관 페이지.
[](https://argusic.com/subject/parlor)질문
- parlor 프로젝트는 실행되나요?
- parlor 프로젝트는 외부 서비스를 mock으로 대체하면 실행됩니다. Argusic은 깨끗한 머신에서 22분 만에 설치하고 실행했으며, 그 과정에서 오류 5개가 발생했고, 세션을 녹화했습니다.
- Argusic은 parlor 프로젝트를 어떻게 테스트했나요?
- 새로운 일회용 머신에서 모든 명령을 기록하며 테스트했습니다. 리포지토리는 commit da1ddf1f3e1a에 고정되었습니다. 기록된 시도는 한 번이며, 전체 방법은 방법론 페이지에 있습니다.
- parlor 테스트 비용은 얼마였나요?
- 이 판정을 낸 실행의 비용은 0.51 USD입니다: 백만 token당 정가가 아니라 실제 컴퓨팅 및 모델 비용입니다. 해당 실행 페이지에 기록되어 있습니다.
- parlor 설치에는 얼마나 걸리나요?
- 이 판정을 결정한 실행에서 깨끗한 머신부터 실행 상태까지 22분이 걸렸습니다. 평균이 아니라 측정된 한 번의 시도입니다.
- parlor 실행에 GPU가 필요한가요?
- 시작하는 데는 필요하지 않습니다. Argusic은 GPU가 없는 머신에서 실행 상태에 도달했습니다.
- parlor 설치 시 어떤 문제가 생기나요?
- 기록된 실행에서 5개의 문제가 발생했습니다. 그중 5개는 사람의 도움 없이 수정되었습니다. 각 문제와 그로 인해 든 시간이 이 페이지에 나와 있습니다.
- parlor 프로젝트는 대안과 비교해 어떤가요?
- Argusic이 설치하고 시간을 잰 apple-silicon 프로젝트 6개 중 parlor 프로젝트는 실행 상태에 4번째로 빨리 도달했으며, 6개 중 2개만 실행 상태에 도달했습니다.
- parlor 프로젝트의 증거는 어디에 있나요?
- 기록된 실행이 이 페이지에 있으며, 각각 전체 log와 터미널 녹화로 연결됩니다. 이들은 몰래 변경할 수 없도록 sha256 지문과 함께 저장됩니다.