英語の原文: https://argusic.com/subject/parlor
parlor
GPT-Live に似た機能を持つ、デバイス上で動作するリアルタイムマルチモーダル AI
モックで動作するソース: GitHubPythonApache-2.0コミット da1ddf1f3e1a
Python、Apache-2.0 ライセンス. プロジェクト自身の表記: apple silicon、gemma、kokoro、litert lm、local llm、mlx、multimodal、on device ai.
parlor は、依存するサービスを代わりのものに置き換えたうえで動作します。Argusic のエージェントが GPU のないクリーンなマシンで 22 分でインストールし、5 件のエラーに遭遇してすべてを自力で修正し、セッション全体が記録されました。
Project installs, builds, and the server starts with Gemma 4 E2B loaded and serving HTTP+WebSocket; the end-to-end AI pipeline (turn detection, llama.cpp inference, transcript parsing, TTS) all initialize and run correctly when tested manually, but the full test suite cannot complete because CPU-only inference exceeds per-turn timeouts, GPU acceleration and/or the smaller e2b model is needed for CI.
クリーンなマシンでエージェントが最終的に得た結果 (エージェント自身の言葉)。 計測方法
Argusic が毎回新しいマシンで計測しています。 すべての数値はその証拠にリンクしています。 Argusic スコア 100 点中 92 点 (このプロジェクトの実行スコアの平均)。
概要
プロジェクトのデータは GitHub から取得 (このページの冒頭にリンクあり)、更新日 。テストデータは Argusic によるもので (CC BY 4.0)、すべての数値は、完全なログ、録画、それらの sha256 ハッシュを含む実行ページにリンクしています。
計測した内容
この判定を決めた実行から取得しています。 各行は記録された値であり、推定値ではありません。
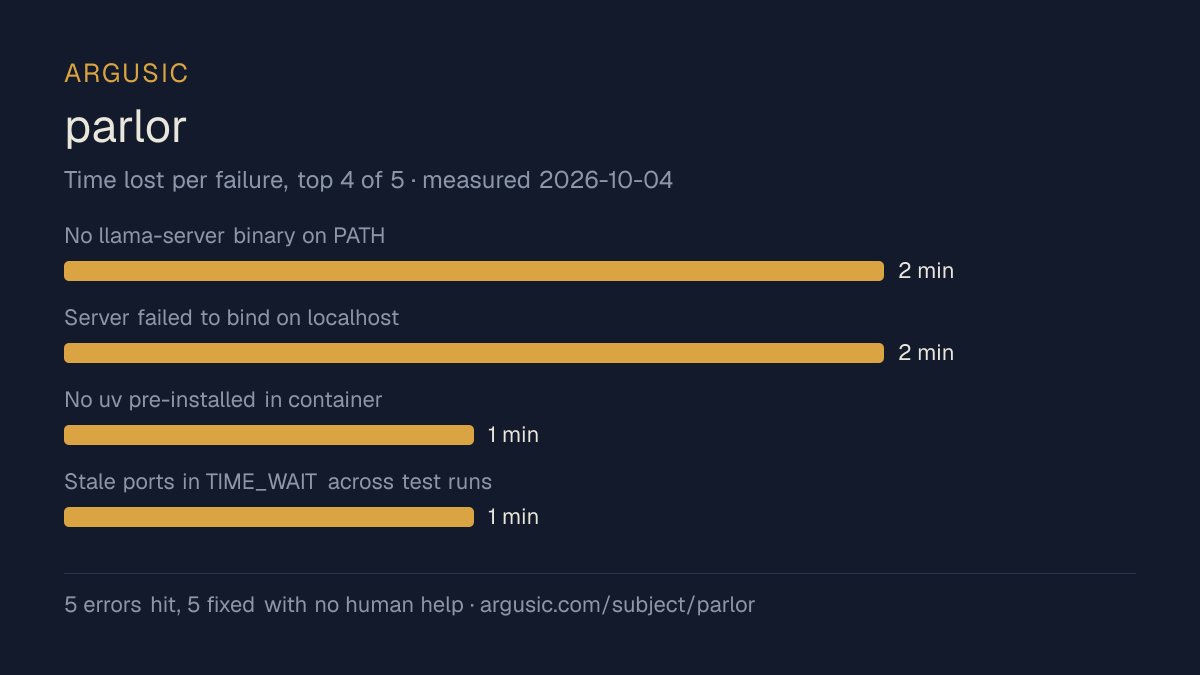
うまくいかなかった点 (エージェント自身の言葉)
エージェント自身の言葉を、深刻なものから順に掲載しています。助言に書き換えることはありません。
- No llama-server binary on PATH2 分
- Server failed to bind on localhost (IPv6 resolved to ::1, not supported)2 分
- No uv pre-installed in container1 分
- Stale ports in TIME_WAIT across test runs1 分
- CPU inference too slow for e2e test suite (70s per turn)
- インストール時間
- 22 分
- クリーンなマシンから完了まで
- 77 分
- 遭遇したエラーと修正したエラー
- 5 件に遭遇、5 件を人の手を借りずに修正
- 結果の証明方法
- uv sync installed all deps; 25 unit tests passed (test_stream_parser.py + test_llama_startup.py); server started on 127.0.0.1:8871 with llama-server b11396 hosting Gemma 4 E2B QAT q4_0; WebSocket accepted, turn detector loaded (smart-turn-v3.2, p=0.99), model inference generated correct reply The capital of France is Paris for capital_france fixture; action decider, TTS backend, and Kokoro-onnx pipeline all initialized without errors. End-to-end test (test_short_question) timed out after 117s due to CPU-only per-turn latency (~70s prefill+decode).
- 使用したモデルのトークン
- 706,028
- テストした正確なコミット
- da1ddf1f3e1a
- コンテナイメージ
- sha256:cdd920bce783
計測していない内容
残りの半分です。この証拠がどこまでを示すのかを正確に確認できます。欠けている部分は欠けているものとして表示し、埋めることはありません。
- GPU メモリのピーク
- CPU マシンで実行したため、サンプリングする GPU がありませんでした
- 長時間の実行での振る舞い
- 各試行はドキュメントにある最小の設定と決まった時間予算を使うため、計測しているのは動作するかどうかであり、負荷のもとでどう持ちこたえるかではありません
- 実際のサービスに対する振る舞い
- この実行は代わりのサービスに対してのみ検証されました
録画の最後
この判定を決めたターミナルセッションの最後の行を、記録されたとおりに表示しています。
- No `llama-server` on PATH → downloaded pre-built `llama-b11396-bin-ubuntu-x64.tar.gz` (CPU build)
- `localhost` resolved to IPv6 `::1` which the container doesn't support → changed `host="127.0.0.1…
- Stale ports 8821–8823 persisted in TIME_WAIT across test runs → shifted to ports 8871–8873
- CPU-only inference is extremely slow (~70s per turn with prefill) because no GPU acceleration wor…
**Model correctness verified**: The server did load the model, accept a WebSocket connection, proce…
exec
/bin/sh -lc "echo 'ARGUSIC_RESULT: {\"install_succeeded\": true, \"launch_succeeded\": true, \"inst…
 succeeded in 0ms:
All done. The project installs, builds, the server starts with Gemma 4 E2B loaded and serving HTTP+…
tokens used
706,028
All done. The project installs, builds, the server starts with Gemma 4 E2B loaded and serving HTTP+…
セッション全体を再生 (クリーンなマシンからこの時点までのすべてのコマンド)。
テスト方法
1 つのエージェント、1 つのコンテナで、人の手は借りません。エージェントはプロジェクト自身のドキュメントに書かれた方法でインストールし、実行し、壊れた部分を修正します。以下はすべて、実際に起きたとおりに記録されています: ターミナルセッション、ログ、そして正確なコミットです。 評価方法の全文.
強みと限界
意見ではなく、計測された事実です。コンテンツの作成方法.
うまくいった点
- 5 件のエラーすべてから、人の介入なしに回復しました。失敗が解決できる程度にはドキュメント化されていることを示しています。
- ホストの報告によると、ライセンスは Apache-2.0 です。
うまくいかなかった点、または不明な点
- 代わりのサービスに対してのみ実行状態に達したため、実際のサービスで動作することはここでは証明されていません。
- インストールに 22 分かかり、Argusic が計測した比較可能な 5 件のプロジェクトの中央値より遅い結果です。
- これまでの計測は 1 回です。1 回の試行は動作し得ることを示すだけで、安定して動作することは示しません。
Argusic がインストールして時間を計測した apple-silicon のプロジェクト 6 件のうち、parlor は実行状態に達するまでの速さが 4 番目で、6 件中 2 件がそもそも実行状態に達しました。
同じ分野でテストしたプロジェクト
ここに挙げたものはすべて、Argusic がクリーンなマシンにインストールして実行しました。テストしていないものは表示されません。
実行履歴
トピック (出典: GitHub)
apple-silicongemmakokorolitert-lmlocal-llmmlxmultimodalon-device-aipythonreal-timespeech-recognitiontext-to-speechvoice-assistant
バッジを埋め込む
プロジェクトの README に貼る Markdown です。バッジはこのページにリンクします。利用条件: 利用規約ページ.
[](https://argusic.com/subject/parlor)質問
- parlor は動作しますか?
- parlor は、外部サービスの代わりにモックを使って動作します. Argusic はクリーンなマシンで 22 分でインストールして起動し、途中で 5 件のエラーに遭遇し、セッションを記録しました。
- Argusic は parlor をどのようにテストしましたか?
- 新しい使い捨てのマシンで、すべてのコマンドを記録しながらテストしました (リポジトリはコミット da1ddf1f3e1a に固定)。記録された試行は 1 回で、手順の全体は評価方法のページに掲載しています。
- parlor のテストにはいくらかかりましたか?
- この判定を出した実行のコストは 0.51 USD です: 100 万トークンあたりの定価ではなく、実際の計算資源とモデルのコストです。その実行のページに記録されています。
- parlor のインストールにはどのくらい時間がかかりますか?
- この判定を決めた実行では、クリーンなマシンから実行状態まで 22 分でした。これは 1 回の計測された試行であり、平均ではありません。
- parlor には GPU が必要ですか?
- 起動には必要ありません。Argusic は GPU のないマシンで実行状態に達しました。
- parlor のインストールでは何がうまくいきませんか?
- 記録された実行では 5 件の問題が発生しました。そのうち 5 件は人の手を借りずに修正されました。それぞれの問題と、かかった時間をこのページに掲載しています。
- parlor は代替のプロジェクトと比べてどうですか?
- Argusic がインストールして時間を計測した apple-silicon のプロジェクト 6 件のうち、parlor は実行状態に達するまでの速さが 4 番目で、6 件中 2 件がそもそも実行状態に達しました。
- parlor の証拠はどこにありますか?
- 記録された実行をこのページに掲載しており、それぞれが完全なログとターミナル録画にリンクしています。録画は sha256 フィンガープリントとともに保存されているため、こっそり改変することはできません。