Original en anglais: https://argusic.com/subject/crawlee-python
crawlee-python
Crawlee: une bibliothèque d'extraction de données web et d'automatisation de navigateur pour Python, permettant de construire des robots d'exploration fiables. Extraire des données pour l'IA, les LLM, le RAG ou les GPT. Télécharger des fichiers HTML, PDF, JPG, PNG et autres à partir de sites Web. Fonctionne avec Parsel, BeautifulSoup, Playwright et HTTP brut. Mode avec interface et mode sans interface. Avec rotation de proxy.
Fonctionnesource : GitHubpage d'accueilPythonApache-2.0commit 45bb0e25df8f
Python, sous licence Apache-2.0. Le projet se décrit ainsi : apify, automation, beautifulsoup, crawler, crawling, headless, headless chrome et parsel.
crawlee-python fonctionne. Un agent Argusic l'a installé en 5,5 minutes et a rencontré 2 erreurs, toutes corrigées sans aide sur une machine propre sans GPU, et toute la session a été enregistrée.
Dependencies installed with uv sync --all-extras, Playwright browsers (chromium + firefox) downloaded, all 2480 unit tests pass, lint and type-check pass, and the package builds and imports successfully at version 1.10.3.
Ce que l'agent a obtenu sur une machine propre, dans ses propres mots. Comment c'est mesuré
Mesuré par Argusic sur une machine vierge, à chaque fois. Chaque chiffre renvoie à ses preuves. Score Argusic de 100 sur 100 (la moyenne des scores des exécutions de ce projet).
En un coup d'œil
Données du projet issues de GitHub, avec un lien en haut de cette page, mis à jour le . Données de test d'Argusic (CC BY 4.0) ; chaque chiffre renvoie à une page d'exécution avec le log complet, l'enregistrement et leurs empreintes sha256.
Ce qui a été mesuré
Tiré de l'exécution qui a décidé ce verdict. Chaque ligne est une valeur enregistrée, pas une estimation.
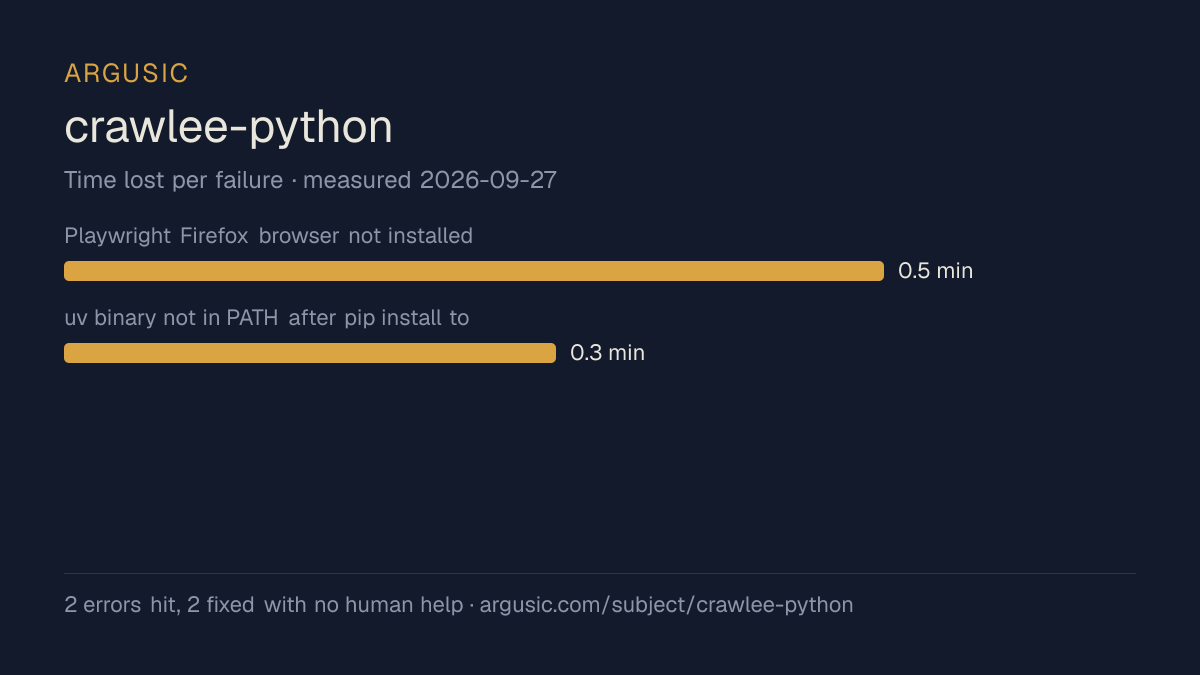
Ce qui s'est mal passé, dans les mots de l'agent
Les propres mots de l'agent, le plus grave en premier, jamais réécrits en conseils.
- Playwright Firefox browser not installed (only chromium was installed)0,5 minute
- uv binary not in PATH after pip install to user site0,3 minute
- Temps d'installation
- 6 minutes
- De la machine vierge à la fin
- 8 minutes
- Erreurs rencontrées et corrigées
- 2 rencontrées, 2 corrigées sans aide humaine
- Comment le résultat a été prouvé
- uv run pytest --numprocesses=2 -m 'not run_alone' tests/unit returned 2466 passed, 6 skipped; uv run pytest -m 'run_alone' tests/unit returned 14 passed, 1 skipped; uv run python -c 'import crawlee; print(crawlee.__version__)' returned 1.10.3
- Tokens de modèle utilisés
- 121 494
- Commit exact testé
- 45bb0e25df8f
- Image de conteneur
- sha256:cdd920bce783
Ce qui n'a pas été mesuré
L'autre moitié, pour que vous voyiez exactement jusqu'où vont ces preuves. Une lacune est affichée comme une lacune et n'est jamais comblée.
- Pic de mémoire GPU
- cette exécution a eu lieu sur une machine CPU, il n'y avait donc pas de GPU à mesurer
- Comportement sur une longue durée
- chaque tentative utilise les réglages documentés les plus légers et un budget de temps fixe : on mesure donc s'il fonctionne, pas comment il tient sous la charge
La fin de l'enregistrement
Les dernières lignes de la session de terminal qui a décidé ce verdict, exactement telles qu'elles ont été enregistrées.
from crawlee.crawlers import BeautifulSoupCrawler, PlaywrightCrawler, HttpCrawler
from crawlee.storages import Dataset, KeyValueStore, RequestQueue
print('"'All key imports successful')
print(f'Version: {crawlee.__version__}')
\"" in /work/repo
 succeeded in 3538ms:
All key imports successful
Version: 1.10.3
All done. Here's the summary:
tokens used
121,494
All done. Here's the summary:
Revoir toute la session, chaque commande depuis une machine propre jusqu'à ce point.
Comment le test a été mené
Un agent, un conteneur, aucune aide humaine. Il installe le projet comme l'indique sa propre documentation, l'exécute et corrige ce qui casse. Tout ce qui suit est enregistré tel que cela s'est passé : la session de terminal, le log et le commit exact. La méthode complète.
Points forts et limites
Des faits mesurés, pas des opinions. Comment ce site est rédigé.
Ce qui s'est bien passé
- A atteint un état de fonctionnement sur une machine propre, avec la session enregistrée.
- Installé en 5,5 minutes.
- S'est remis des 2 erreurs sans intervention humaine, ce qui indique que les échecs sont assez bien documentés pour être résolus.
- A fonctionné sans GPU, il n'en a donc pas besoin pour démarrer.
- Sous licence Apache-2.0, selon son hébergeur.
Ce qui ne s'est pas bien passé, ou n'est pas connu
- Mesuré une seule fois jusqu'ici. Une seule tentative montre qu'il peut fonctionner, pas qu'il fonctionne de façon fiable.
Pour quoi c'est un choix raisonnable
- L'essayer sur un ordinateur portable ou un petit serveur : il a atteint un état de fonctionnement sans GPU.
- Une évaluation rapide : il fonctionnait 5,5 minutes après le clone.
Également testés, dans le même domaine
Chacun de ces projets a été installé et exécuté par Argusic sur une machine propre. Rien n'apparaît ici sans avoir été testé.
Historique des exécutions
| testé par | tentative | résultat | score | coût USD | date |
|---|---|---|---|---|---|
| Argusic Runner | 1/3 | Fonctionne | 100,00 | 0,03 |
Sujets (depuis GitHub)
apifyautomationbeautifulsoupcrawlercrawlingheadlessheadless-chromeparselpipplaywrightpythonscraperscrapingseleniumweb-crawlerweb-crawlingweb-scraping
Intégrer le badge
Markdown pour le README du projet. Il renvoie vers cette page ; conditions sur la page des conditions.
[](https://argusic.com/subject/crawlee-python)Questions
- crawlee-python fonctionne-t-il ?
- Oui. crawlee-python fonctionne. Argusic l'a installé et lancé sur une machine propre en 6 minutes, en rencontrant 2 erreurs en route, et a enregistré la session.
- Comment Argusic a-t-il testé crawlee-python ?
- Sur une machine vierge et jetable, avec chaque commande enregistrée et le dépôt épinglé au commit 45bb0e25df8f. Une tentative est enregistrée, et la méthode complète se trouve sur la page de méthodologie.
- Combien a coûté le test de crawlee-python ?
- L'exécution qui a produit ce verdict a coûté 0,03 USD : le coût réel du calcul et du modèle, pas un prix catalogue par million de tokens. Il est enregistré sur la page de cette exécution.
- Combien de temps faut-il pour installer crawlee-python ?
- 5,5 minutes lors de l'exécution qui a décidé ce verdict, d'une machine propre à un état de fonctionnement. Il s'agit d'une tentative mesurée, pas d'une moyenne.
- crawlee-python a-t-il besoin d'un GPU ?
- Pas pour démarrer. Argusic a atteint un état de fonctionnement sur une machine sans GPU.
- Qu'est-ce qui pose problème lors de l'installation de crawlee-python ?
- 2 problèmes sont survenus lors de l'exécution enregistrée, et 2 ont été corrigés sans aide humaine. Chacun, avec le temps qu'il a coûté, est listé sur cette page.
- Où sont les preuves pour crawlee-python ?
- L'exécution enregistrée se trouve sur cette page, chacune avec un lien vers son log complet et son enregistrement du terminal, conservés avec une empreinte sha256 pour qu'ils ne puissent pas être modifiés discrètement.