Bản gốc tiếng Anh: https://argusic.com/subject/skill-conductor
skill-conductor
Vòng đời skill ưu tiên kiến trúc cho AI agents. BinEval binary scoring với các judges được hiệu chỉnh chéo giữa các họ và không phụ thuộc ngưỡng, vòng lặp tự cập nhật có kiểm soát, kiểm thử áp lực, và 10 nguyên tắc biên soạn dựa trên nghiên cứu thực nghiệm.
Chạy được với mocknguồn: GitHubtrang chủ dự ánPythonMITcommit 3c21d2f19c33
Python, giấy phép MIT. Dự án tự gắn nhãn: agent skills, ai agents, anthropic, claude code, claude plugin, claude skill, knowledge management và llm.
skill-conductor chạy được, với dịch vụ giả lập thay cho các dịch vụ nó phụ thuộc. Trên một máy sạch không có GPU, một agent của Argusic đã cài đặt nó trong 1 phút, gặp 2 lỗi và tự sửa hết mà không cần trợ giúp, và toàn bộ phiên làm việc được ghi lại.
All 13 Python scripts in skill-conductor successfully parse and run: smoke tests pass (12/12), structural eval passes (22/22, score 10/10), skill init creates valid structure, packaging produces valid .skill zip, and scripts requiring LLM access (run_eval, improve_description, run_loop) parse their args correctly but need ANTHROPIC_API_KEY to execute real evaluations.
Kết quả agent đạt được trên máy sạch, bằng chính lời của nó. Cách đo
Argusic đo trên một máy mới mỗi lần. Mỗi con số đều link tới bằng chứng của nó. Điểm Argusic 92 trên 100 (trung bình điểm các lần chạy của dự án này).
Tóm tắt
Dữ liệu dự án lấy từ GitHub, có link ở đầu trang, cập nhật . Dữ liệu test của Argusic (CC BY 4.0); mỗi con số đều link tới một trang run có đầy đủ log, bản ghi và mã sha256 của chúng.
Những gì đã đo
Lấy từ lần chạy quyết định kết luận này. Mỗi dòng là một giá trị được ghi lại, không phải ước tính.
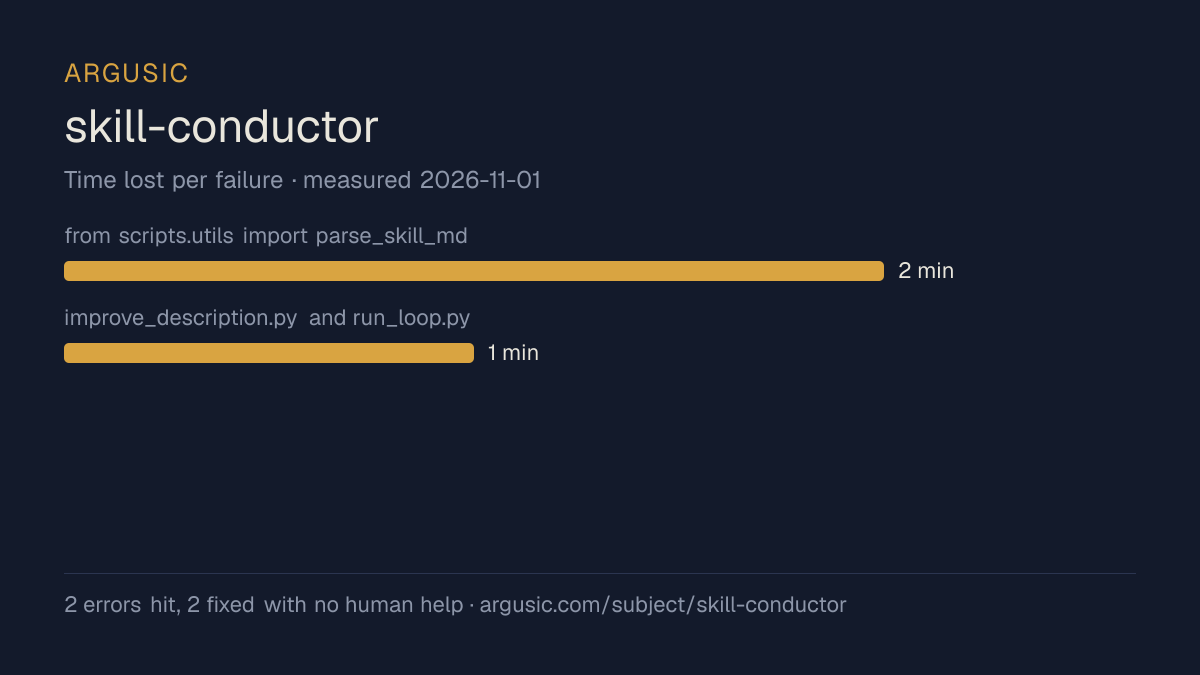
Những gì trục trặc, bằng chính lời của agent
Lời của chính agent, lỗi nặng nhất trước, không bao giờ viết lại thành lời khuyên.
- from scripts.utils import parse_skill_md fails under uv run — scripts/ is not a package2 phút
- improve_description.py and run_loop.py missing inline dependency header for anthropic1 phút
- Thời gian cài đặt
- 1 phút
- Từ máy sạch đến khi xong
- 6 phút
- Lỗi gặp và đã sửa
- gặp 2, tự sửa 2 mà không cần người giúp
- Cách chứng minh kết quả
- uv run scripts/test_smoke.py exited 0, 12/12 passed; uv run scripts/eval_skill.py . returned 22/22 passed, score 10/10; all 11 CLI scripts respond to --help/usage
- Số token model đã dùng
- 255.210
- Commit chính xác đã test
- 3c21d2f19c33
- Container image
- sha256:cdd920bce783
Những gì chưa đo
Nửa còn lại, để bạn thấy rõ bằng chứng này đi xa tới đâu. Chỗ trống được ghi là chỗ trống và không bao giờ được lấp vào.
- Bộ nhớ GPU cao nhất
- lần này chạy trên máy CPU, nên không có GPU để đo
- Hoạt động khi chạy lâu
- mỗi lần thử dùng cấu hình nhỏ nhất có trong tài liệu và một khoảng thời gian cố định, nên đây là đo xem nó có chạy hay không, không đo nó chịu tải ra sao
- Hoạt động với dịch vụ thật
- lần chạy này chỉ được kiểm chứng với dịch vụ giả lập
Xem phiên làm việc
Toàn bộ lần chạy, từ máy sạch, đúng tốc độ thực tế. Không cắt và không tua nhanh đoạn nào.
Bản ghi của lần thử 1, chạy ngày , lần thử đã quyết định kết luận ở trên. Bản terminal recording dùng để làm video này là bằng chứng, được lưu với dấu vân tay sha256; video chỉ là bản dựng từ nó. Không có gì tải từ trang chứa video cho tới khi bạn bấm phát.
Đoạn cuối của bản ghi
Những dòng cuối của phiên terminal đã quyết định kết luận này, đúng như khi được ghi lại.
| Error | Fix | Time |
|-------|-----|------|
| 3 scripts (`run_eval.py`, `improve_description.py`, `run_loop.py`) used `from scripts.utils impor…
| `improve_description.py` and `run_loop.py` lacked inline `# /// script` dependency headers for `a…
**Verification**:
- `uv run scripts/test_smoke.py` → 12/12 passed
- `uv run scripts/eval_skill.py .` → 22/22 passed, score 10/10
- `uv run scripts/eval_skill.py . --json` → 17 deterministic records, all pass (5 critical)
- `uv run scripts/init_skill.py` → creates valid skill structure
- `uv run scripts/package_skill.py` → creates valid `.skill` zip
- All 11 scripts with CLIs respond to `--help` or usage
- Scripts requiring `claude` CLI or `ANTHROPIC_API_KEY` (`run_eval.py`, `improve_description.py`, `…
Xem lại toàn bộ phiên, mọi lệnh từ máy sạch tới thời điểm này.
Cách test
Một agent, một container, không có người giúp. Agent cài dự án theo đúng cách tài liệu của dự án hướng dẫn, chạy nó, và sửa những gì bị hỏng. Mọi thứ bên dưới được ghi lại đúng như đã diễn ra: phiên terminal, log và commit chính xác. Toàn bộ phương pháp.
Điểm mạnh và giới hạn
Dữ kiện đo được, không phải ý kiến. Cách viết nội dung.
Những gì suôn sẻ
- Cài đặt trong 1 phút, nhanh hơn trung vị của 106 dự án tương đương mà Argusic đã đo.
- Tự khắc phục cả 2 lỗi mà không cần người can thiệp, cho thấy các lỗi được ghi trong tài liệu đủ rõ để giải quyết.
- Giấy phép MIT, theo thông tin từ nơi lưu trữ dự án.
Những gì không suôn sẻ, hoặc chưa biết
- Chỉ đạt trạng thái chạy được với dịch vụ giả lập, nên ở đây không có gì chứng minh nó chạy với dịch vụ thật.
- Mới đo một lần. Một lần thử cho thấy nó có thể chạy, chưa cho thấy nó chạy ổn định.
Trong 107 dự án agent-skills mà Argusic đã cài đặt và bấm giờ, skill-conductor đứng thứ 22 về tốc độ đạt trạng thái chạy được, và 78 trên 107 dự án đạt được trạng thái đó.
Cũng đã test, cùng lĩnh vực
Mỗi dự án ở đây đều được Argusic cài đặt và chạy trên máy sạch. Không có dự án nào chưa test xuất hiện ở đây.
Lịch sử chạy
| test bởi | lần thử | kết quả | điểm | chi phí USD | thời điểm |
|---|---|---|---|---|---|
| Argusic Runner | 1/3 | Chạy được với mock | 92,00 | 0,05 |
Chủ đề (từ GitHub)
agent-skillsai-agentsanthropicclaude-codeclaude-pluginclaude-skillknowledge-managementllmobsidianpersonal-assistantproductivityprompt-engineeringsecond-brainskill-authoringskillstdd
Nhúng badge
Markdown cho README của dự án. Badge link về trang này; điều khoản ở trang điều khoản.
[](https://argusic.com/subject/skill-conductor)Câu hỏi
- skill-conductor có chạy được không?
- skill-conductor chạy được, với mock thay cho các dịch vụ bên ngoài. Argusic đã cài đặt và khởi chạy nó trên một máy sạch trong 1 phút, gặp 2 lỗi trên đường đi, và ghi lại phiên làm việc.
- Argusic đã test skill-conductor như thế nào?
- Trên một máy mới, dùng một lần, mọi lệnh đều được ghi lại và repo được ghim ở commit 3c21d2f19c33. Có một lần thử được ghi lại, và toàn bộ phương pháp nằm ở trang phương pháp.
- Test skill-conductor tốn bao nhiêu?
- Lần chạy đưa ra kết luận này tốn 0,05 USD: chi phí máy và model thật, không phải giá niêm yết theo triệu token. Con số được ghi trên trang của lần chạy đó.
- Cài đặt skill-conductor mất bao lâu?
- 1 phút trong lần chạy quyết định kết luận này, từ máy sạch đến trạng thái chạy được. Đó là một lần thử đo được, không phải số trung bình.
- skill-conductor có cần GPU không?
- Không cần để khởi động. Argusic đã đạt trạng thái chạy được trên một máy không có GPU.
- Cài đặt skill-conductor thì gặp lỗi gì?
- 2 lỗi xảy ra trong lần chạy được ghi lại, và 2 lỗi đã được sửa mà không cần người giúp. Từng lỗi, cùng thời gian nó tốn, được liệt kê trên trang này.
- skill-conductor so với các lựa chọn khác thế nào?
- Trong 107 dự án agent-skills mà Argusic đã cài đặt và bấm giờ, skill-conductor đứng thứ 22 về tốc độ đạt trạng thái chạy được, và 78 trên 107 dự án đạt được trạng thái đó.
- Bằng chứng cho skill-conductor ở đâu?
- Lần chạy được ghi lại nằm trên trang này, mỗi lần link tới log đầy đủ và terminal recording, được lưu kèm dấu vân tay sha256 để không thể bị sửa lén.