Englisches Original: https://argusic.com/subject/parlant
parlant
Parlant ist eine offene Plattform zum Erstellen von kundenorientierten Chat-Agenten mit KI. Beschreiben Sie, wie sich der Agent verhalten soll, und Ihr Coding-Agent implementiert es für Sie.
Läuft mit MocksQuelle: GitHubHomepagePythonApache-2.0Commit ea737442b8ae
Python, Lizenz Apache-2.0. Das Projekt beschreibt sich selbst als: ai agent, customer experience, customer service, customer success, lead generation, llm und python.
parlant läuft, mit Ersatz für die Dienste, von denen es abhängt. Ein Argusic-Agent hat es in 12 Minuten installiert und ist auf 8 Fehler gestoßen. Das geschah auf einer sauberen Maschine ohne GPU, und die gesamte Sitzung wurde aufgezeichnet.
With a schema-correct mock NLP backend, the Parlant server started on port 18999, answered /healthz 200, created agents/guidelines/sessions (201), and ran the engine to completion status; 208 API tests passed while the parlant CLI remained unimportable.
Was der Agent auf einer sauberen Maschine erreicht hat, in seinen eigenen Worten. So wird gemessen
Von Argusic jedes Mal auf einer frischen Maschine gemessen. Jede Zahl verlinkt auf ihren Nachweis. Argusic Score 86,2 von 100 (der Mittelwert der Lauf-Scores dieses Projekts).
Auf einen Blick
Projektdaten von GitHub, oben auf dieser Seite verlinkt, aktualisiert . Testdaten von Argusic (CC BY 4.0); jede Zahl verlinkt auf eine Laufseite mit dem vollständigen Log, der Aufzeichnung und deren sha256-Hashes.
Was gemessen wurde
Aus dem Lauf, der diesen Befund entschieden hat. Jede Zeile ist ein aufgezeichneter Wert, keine Schätzung.
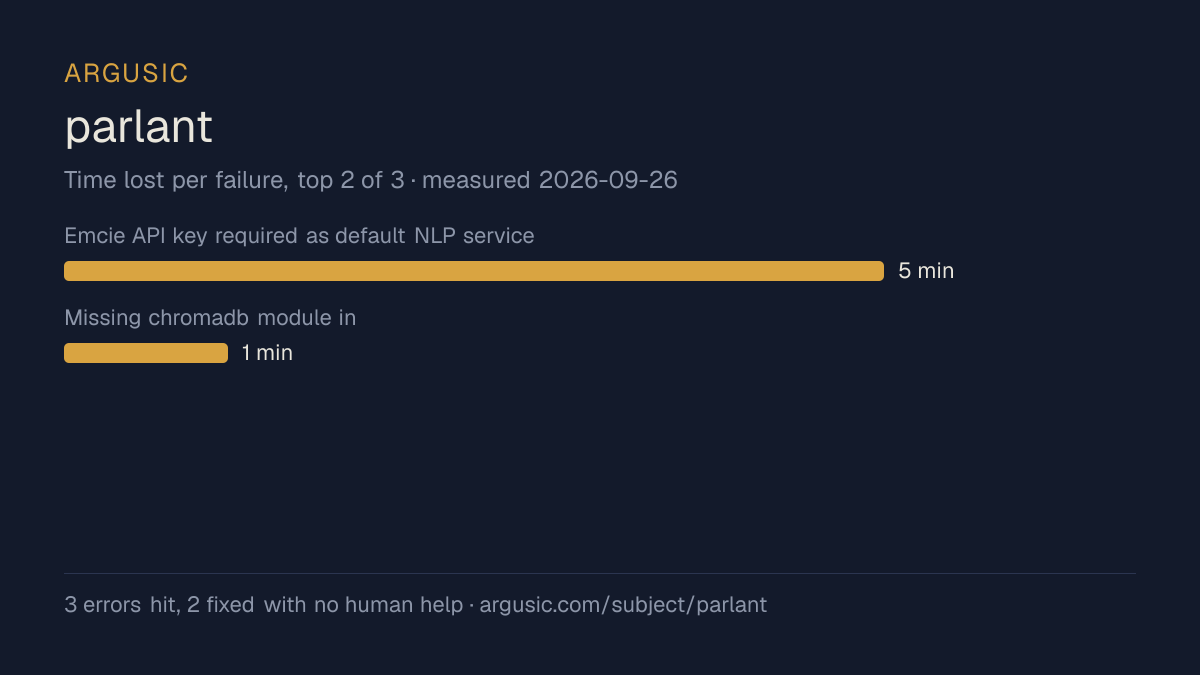
Was schiefging, in den Worten des Agents
Die eigenen Worte des Agents, das Schwerste zuerst, nie zu Ratschlägen umgeschrieben.
- parlant CLI fails: ImportError cannot import JourneyTriggerUpdateParams from parlant.client.types12 Minuten
- Tests failed with KeyError('EMCIE_API_KEY') because tests/conftest.py hardcodes EmcieService8 Minuten
- pytest collection failed on missing qdrant_client, chroma, pymongo, litellm, azure, zhipuai modules4 Minuten
- README claims OpenAI is the default NLP provider but p.Server() defaults to NLPServices.emcie and fails without EMCIE_API_KEY4 Minuten
- Embedding dimension mismatch (128 mock dims vs 3072 expected)3 Minuten
- test_embedding/test_generation fail: HealthReporter.__init__() missing required positional argument application_context3 Minuten
- Installationszeit
- 12 Minuten
- Von der kalten Maschine bis zum Ende
- 54 Minuten
- Aufgetretene und behobene Fehler
- 8 aufgetreten, 6 ohne menschliche Hilfe behoben
- Wie das Ergebnis belegt wurde
- curl -s -o /dev/null -w %{http_code} localhost:18999/healthz returned 200; POST /agents returned 201; POST /sessions returned 201; engine emitted acknowledged/processing/typing/ready status events; pytest run with mock Emcie/OpenAI servers reported '208 passed' on API modules and '229 passed, 1 failed' on the mixed suite; uv run parlant-server run --version printed 'Parlant v3.3.1'
- Verbrauchte Modell-Tokens
- 899.179
- Genau getesteter Commit
- ea737442b8ae
- Container-Image
- sha256:cdd920bce783
Was nicht gemessen wurde
Die andere Hälfte, damit Sie genau sehen, wie weit dieser Nachweis reicht. Eine Lücke wird als Lücke angezeigt und nie aufgefüllt.
- Maximaler GPU-Speicher
- dieser Lauf fand auf einer CPU-Maschine statt, es gab also keine GPU zu messen
- Verhalten über einen langen Lauf
- jeder Versuch verwendet die kleinsten dokumentierten Einstellungen und ein festes Zeitbudget, daher misst dies, ob es läuft, nicht wie es sich unter Last hält
- Verhalten gegenüber echten Diensten
- dieser Lauf wurde nur gegen Ersatzdienste verifiziert
Das Ende der Aufzeichnung
Die letzten Zeilen der Terminalsitzung, die diesen Befund entschieden hat, genau so, wie sie aufgezeichnet wurden.
899,179
All work is complete. Summary of what I observed, followed by the required result line.
**What worked**
- `uv sync --group dev --extra chroma --extra mongo --extra qdrant --extra litellm --extra azure --…
- `uv run parlant-server run --version` printed `Parlant v3.3.1`.
- Server launched against a schema-correct Argusic-compatible mock: `GET /healthz`→200, `GET /agent…
- README SDK flow (`p.Server(nlp_service=p.NLPServices.openai)` + `create_agent`) created an agent …
- Test suite with in-process schema-correct Emcie mock: 208 API tests passed, 0 failed; 229 passed …
**Unresolved**
- `parlant` CLI crashes on import: `parlant-client` pinned at v3.2.0 lacks `JourneyTriggerUpdatePar…
- README states Argusic is the default NLP provider, but `p.Server()` actually defaults to `NLPServ…
- Some tests call `HealthReporter()` without the now-required `application_context`.
Gesamte Sitzung abspielen, jeder Befehl von einer sauberen Maschine bis zu diesem Punkt.
So wurde getestet
Ein Agent, ein Container, keine menschliche Hilfe. Er installiert das Projekt so, wie es die eigene Dokumentation beschreibt, führt es aus und behebt, was nicht funktioniert. Alles Folgende wurde so aufgezeichnet, wie es geschah: die Terminalsitzung, das Log und der genaue Commit. Die vollständige Methodik.
Stärken und Grenzen
Gemessene Fakten, keine Meinungen. Wie diese Inhalte entstehen.
Was gut lief
- Lizenz Apache-2.0, laut Angabe des Hosts.
- 2-mal gemessen, das Ergebnis ist also kein Einzelfall.
Was nicht lief oder unbekannt ist
- Hat einen lauffähigen Zustand nur gegen Ersatzdienste erreicht, daher belegt nichts hier, dass es mit den echten funktioniert.
- Die Installation dauerte 12 Minuten, langsamer als der Median der 110 vergleichbaren Projekte, die Argusic gemessen hat.
- Ist bei der Einrichtung auf 8 Fehler gestoßen, davon 2 nicht gelöst.
Von den 111 Projekten im Bereich ai-agents, die Argusic installiert und zeitlich gemessen hat, belegte parlant Platz 73 bei der Zeit bis zum lauffähigen Zustand, und 83 von 111 erreichten überhaupt einen solchen Zustand.
Ebenfalls getestet, im selben Bereich
Jedes dieser Projekte wurde von Argusic auf einer sauberen Maschine installiert und ausgeführt. Hier erscheint nichts, was nicht getestet wurde.
Laufverlauf
| getestet von | Versuch | Ergebnis | Score | Kosten USD | wann |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Läuft mit Mocks | 87,00 | 1,05 | |
| Argusic Runner | 1/3 | Läuft mit Mocks | 85,33 | 0,17 |
Themen (von GitHub)
ai-agentcustomer-experiencecustomer-servicecustomer-successlead-generationllmpython
Badge einbetten
Markdown für die README des Projekts. Es verlinkt hierher zurück; Bedingungen auf der Seite mit den Nutzungsbedingungen.
[](https://argusic.com/subject/parlant)Fragen
- Läuft parlant?
- parlant läuft, mit Mocks als Ersatz für externe Dienste. Argusic hat es auf einer sauberen Maschine in 12 Minuten installiert und gestartet, ist dabei auf 8 Fehler gestoßen und hat die Sitzung aufgezeichnet.
- Wie hat Argusic parlant getestet?
- Auf einer frischen Einwegmaschine, mit jedem Befehl aufgezeichnet und dem Repository fixiert auf Commit ea737442b8ae. 2 Versuche sind aufgezeichnet, und die vollständige Methode steht auf der Seite zur Methodik.
- Was hat der Test von parlant gekostet?
- Der Lauf, der diesen Befund ergab, kostete 1,05 USD: echte Rechen- und Modellkosten, kein Listenpreis pro Million Tokens. Der Betrag ist auf der Seite dieses Laufs aufgezeichnet.
- Wie lange dauert die Installation von parlant?
- 12 Minuten in dem Lauf, der diesen Befund entschieden hat, von einer sauberen Maschine bis zum lauffähigen Zustand. Das ist ein gemessener Versuch, kein Durchschnitt.
- Braucht parlant eine GPU?
- Nicht zum Starten. Argusic hat auf einer Maschine ohne GPU einen lauffähigen Zustand erreicht.
- Was geht bei der Installation von parlant schief?
- Im aufgezeichneten Lauf gingen 8 Dinge kaputt, und 6 davon wurden ohne menschliche Hilfe behoben. Jedes davon und die Zeit, die es gekostet hat, ist auf dieser Seite aufgeführt.
- Wie schneidet parlant im Vergleich zu Alternativen ab?
- Von den 111 Projekten im Bereich ai-agents, die Argusic installiert und zeitlich gemessen hat, belegte parlant Platz 73 bei der Zeit bis zum lauffähigen Zustand, und 83 von 111 erreichten überhaupt einen solchen Zustand.
- Wo ist der Nachweis für parlant?
- Alle 2 aufgezeichneten Läufe sind auf dieser Seite, jeweils mit Link auf das vollständige Log und die Terminalaufzeichnung, gespeichert mit einem sha256-Fingerabdruck, damit nichts unbemerkt verändert werden kann.