Original en inglés: https://argusic.com/subject/unlimited-ocr
Unlimited-OCR
Trabajos de OCR ilimitados: Bienvenida la era del parseo one-shot de horizonte largo.
Funciona con mocksfuente: GitHubPythonMITcommit 92ad94b53a51
Python, licencia MIT.
Unlimited-OCR funciona, con sustitutos de los servicios de los que depende. Un agent de Argusic lo instaló en 8 minutos y encontró 4 errores, todos corregidos sin ayuda en una máquina limpia sin GPU, y toda la sesión quedó grabada.
The Unlimited-OCR client (infer.py) installed and ran end-to-end against a schema-correct mock SGLang server, correctly processing 1 image and 14 PDF pages with streamed responses and writing all 15 markdown outputs; the real GPU SGLang server and real model weights were not run due to no accelerator in this container.
Lo que el agent consiguió en una máquina limpia, en sus propias palabras. Cómo se mide
Medido por Argusic en una máquina limpia cada vez. Cada cifra enlaza a su evidencia. Puntuación Argusic de 92 sobre 100 (la media de las puntuaciones de las ejecuciones de este proyecto).
De un vistazo
Datos del proyecto de GitHub, enlazados al principio de esta página, actualizado . Datos de prueba de Argusic (CC BY 4.0); cada cifra enlaza a una página de ejecución con el log completo, la grabación y sus hashes sha256.
Qué se midió
De la ejecución que decidió este veredicto. Cada línea es un valor registrado, no una estimación.
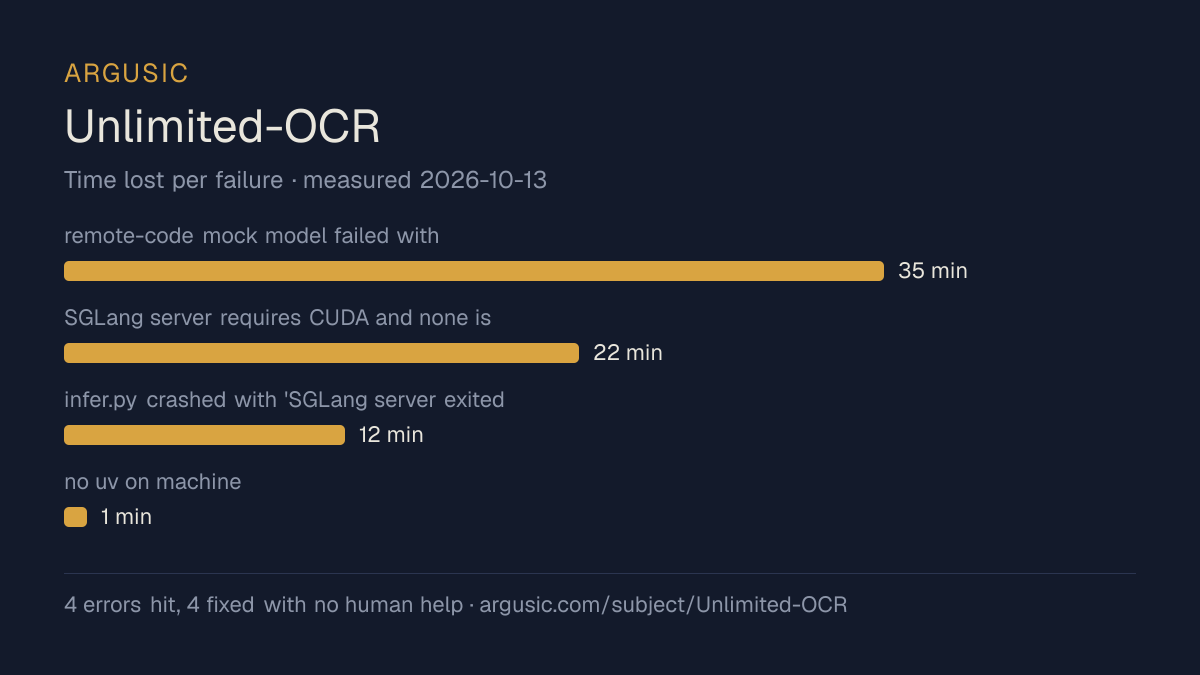
Qué salió mal, en palabras del propio agent
Las palabras del propio agent, de lo más grave a lo menos, nunca reescritas como consejos.
- remote-code mock model failed with DynamicCache error, tuple output, missing ModelOutput import, and malformed tokenizer.json35 minutos
- SGLang server requires CUDA and none is present22 minutos
- infer.py crashed with 'SGLang server exited early' even though a healthy server was already up12 minutos
- no uv on machine1 minuto
- Tiempo de instalación
- 8 minutos
- De máquina en frío a terminar
- 14 minutos
- Errores encontrados y corregidos
- 4 encontrados, 4 corregidos sin ayuda humana
- Cómo se demostró el resultado
- python infer.py --image_dir /tmp --output_dir /tmp/out_imgs --concurrency 4 --image_mode gundam -> Requests 1/1, Total tokens 8; python infer.py --pdf ./Unlimited-OCR.pdf --output_dir /tmp/out_pdf --concurrency 2 --image_mode base -> Requests 14/14, Total tokens 112; ffmpeg -v error -f null - returned no decode errors on both PNG and GIF assets
- Tokens de modelo usados
- 577.758
- Commit exacto probado
- 92ad94b53a51
- Imagen del contenedor
- sha256:cdd920bce783
Qué no se midió
La otra mitad, para que veas exactamente hasta dónde llega esta evidencia. Un hueco se muestra como hueco y nunca se rellena.
- Memoria de GPU máxima
- se ejecutó en una máquina con CPU, así que no había GPU que muestrear
- Comportamiento en una ejecución larga
- cada intento usa la configuración documentada más pequeña y un presupuesto de tiempo fijo, así que esto mide si funciona, no cómo aguanta bajo carga
- Comportamiento con servicios reales
- esta ejecución solo se verificó con servicios sustitutos
Ver la sesión
La ejecución completa, desde una máquina limpia, a la velocidad a la que ocurrió. No se ha cortado ni acelerado nada.
Una grabación del intento 1, ejecutado el , el intento que decidió el veredicto anterior. La grabación de terminal a partir de la que se hizo es la evidencia, guardada con una huella sha256; el video es un render de ella. No se carga nada del servicio de video hasta que pulses reproducir.
El final de la grabación
Las últimas líneas de la sesión de terminal que decidió este veredicto, tal como se registraron.
- SGLang server cannot start without a GPU (expected) → mocked a real SGLang-style HTTP endpoint so…
- When a healthy server was already present, `infer.py` still crashed with "SGLang server exited ea…
- The standalone remote-code mock model needed `auto_map`, a working `DynamicCache`-compliant `forw…
**Verified facts**
- `infer.py --image_dir /tmp --output_dir /tmp/out_imgs --concurrency 4 --image_mode gundam` → `Req…
- `infer.py --pdf ./Unlimited-OCR.pdf --output_dir /tmp/out_pdf --concurrency 2 --image_mode base` …
- `ffmpeg -v error -i /tmp/doc.png -f null -` and `ffmpeg -v error -i assets/long-horizon-ocr.gif -…
- Real network access to the model exists (HF API lists the weights, 6.7 GB single safetensor), so …
**Record of what the mock is vs. what can't be verified**
- The mock is a hand-written FastAPI server emulating the SGLang SSE contract on port 10000. The cl…
- What is NOT verified: any real OCR output, any real GPU inference, the SGLang server boot. Those …
`install_succeeded=true`, `launch_succeeded=true` (client tool ran; the SGLang server itself cannot…
Reproducir la sesión completa, cada comando desde una máquina limpia hasta este punto.
Cómo se probó
Un agent, un contenedor, sin ayuda humana. Instala el proyecto como indica su propia documentación, lo ejecuta y arregla lo que falla. Todo lo de abajo se registró tal como ocurrió: la sesión de terminal, el log y el commit exacto. La metodología completa.
Puntos fuertes y límites
Hechos medidos, no opiniones. Cómo se redacta.
Qué salió bien
- Se recuperó de los 4 errores sin que interviniera una persona, lo que indica que los fallos están lo bastante documentados como para resolverlos.
- Licencia MIT, según su plataforma de origen.
- Medido 2 veces, así que el resultado no es algo puntual.
Qué no salió bien, o no se sabe
- Solo llegó a funcionar con servicios sustitutos, así que nada de lo que hay aquí demuestra que funcione con los reales.
- Tardó 8 minutos en instalarse, más lento que la mediana de los 46 proyectos comparables que ha medido Argusic.
De los 47 proyectos de Python que Argusic ha instalado y cronometrado, Unlimited-OCR fue el 37.º más rápido en llegar a funcionar, y 28 de 47 llegaron a funcionar.
Historial de ejecuciones
| probado por | intento | resultado | puntuación | costo USD | cuándo |
|---|---|---|---|---|---|
| Argusic Runner | 2/3 | Se quedó sin tiempo | 0,00 | 1,03 | |
| Argusic Runner | 1/3 | Funciona con mocks | 92,00 | 0,14 |
Insertar el badge
Markdown para el README del proyecto. Enlaza de vuelta aquí; condiciones en la página de términos.
[](https://argusic.com/subject/unlimited-ocr)Preguntas
- ¿Funciona Unlimited-OCR?
- Unlimited-OCR funciona, con mocks en lugar de los servicios externos. Argusic lo instaló y lo inició en una máquina limpia en 8 minutos, con 4 errores por el camino, y grabó la sesión.
- ¿Cómo probó Argusic Unlimited-OCR?
- En una máquina limpia y desechable, con cada comando grabado y el repositorio fijado en el commit 92ad94b53a51. Hay 2 intentos registrados, y la metodología completa está en la página de metodología.
- ¿Cuánto costó probar Unlimited-OCR?
- La ejecución que produjo este veredicto costó 0,14 USD: costo real de cómputo y de modelo, no un precio de lista por millón de tokens. Consta en la página de esa ejecución.
- ¿Cuánto tarda Unlimited-OCR en instalarse?
- 8 minutos en la ejecución que decidió este veredicto, desde una máquina limpia hasta que funcionó. Es un intento medido, no una media.
- ¿Necesita Unlimited-OCR una GPU?
- No para arrancar. Argusic consiguió que funcionara en una máquina sin GPU.
- ¿Qué falla al instalar Unlimited-OCR?
- En la ejecución registrada fallaron 4 cosas, y 4 se corrigieron sin ayuda humana. Cada una, con el tiempo que costó, aparece en esta página.
- ¿Cómo se compara Unlimited-OCR con las alternativas?
- De los 47 proyectos de Python que Argusic ha instalado y cronometrado, Unlimited-OCR fue el 37.º más rápido en llegar a funcionar, y 28 de 47 llegaron a funcionar.
- ¿Dónde está la evidencia de Unlimited-OCR?
- Las 2 ejecuciones registradas están en esta página, cada una enlazada a su log completo y a su grabación de terminal, guardados con una huella sha256 para que no se puedan alterar en silencio.