Englisches Original: https://argusic.com/subject/quillman
quillman
Eine Sprach-Chat-App
Läuft mit MocksQuelle: GitHubHomepagePythonMITCommit 7ed27b446538
Python, Lizenz MIT. Das Projekt beschreibt sich selbst als: ai, language model, python, serverless, speech recognition und speech to text.
quillman läuft, mit Ersatz für die Dienste, von denen es abhängt. Ein Argusic-Agent hat es in 1,1 Minuten installiert und ist auf 3 Fehler gestoßen und hat jeden davon ohne Hilfe behoben. Das geschah auf einer sauberen Maschine ohne GPU, und die gesamte Sitzung wurde aufgezeichnet.
The QuiLLMan frontend and websocket adapter run locally via uvicorn on port 8000 with a mocked Modal layer serving both the React frontend (200 on /) and a FastAPI websocket endpoint (200 on /status, echo responses on /ws)
Was der Agent auf einer sauberen Maschine erreicht hat, in seinen eigenen Worten. So wird gemessen
Von Argusic jedes Mal auf einer frischen Maschine gemessen. Jede Zahl verlinkt auf ihren Nachweis. Argusic Score 92 von 100 (der Mittelwert der Lauf-Scores dieses Projekts).
Auf einen Blick
Projektdaten von GitHub, oben auf dieser Seite verlinkt, aktualisiert . Testdaten von Argusic (CC BY 4.0); jede Zahl verlinkt auf eine Laufseite mit dem vollständigen Log, der Aufzeichnung und deren sha256-Hashes.
Was gemessen wurde
Aus dem Lauf, der diesen Befund entschieden hat. Jede Zeile ist ein aufgezeichneter Wert, keine Schätzung.
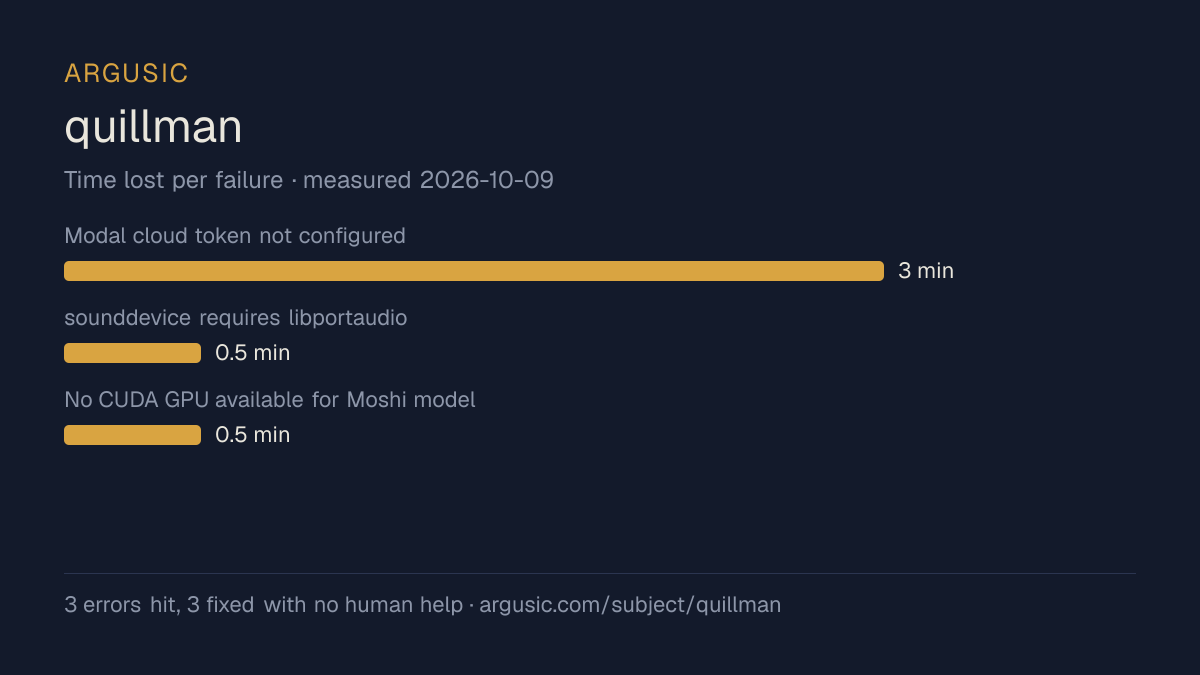
Was schiefging, in den Worten des Agents
Die eigenen Worte des Agents, das Schwerste zuerst, nie zu Ratschlägen umgeschrieben.
- Modal cloud token not configured3 Minuten
- sounddevice requires libportaudio (system package)0,5 Minuten
- No CUDA GPU available for Moshi model inference0,5 Minuten
- Installationszeit
- 1 Minuten
- Von der kalten Maschine bis zum Ende
- 11 Minuten
- Aufgetretene und behobene Fehler
- 3 aufgetreten, 3 ohne menschliche Hilfe behoben
- Wie das Ergebnis belegt wurde
- venv/bin/python run_local.py serves on port 8000; curl /status returns 200, curl / returns 200, WS e2e test sent 10 Opus chunks and received 30 responses
- Verbrauchte Modell-Tokens
- 130.751
- Genau getesteter Commit
- 7ed27b446538
- Container-Image
- sha256:cdd920bce783
Was nicht gemessen wurde
Die andere Hälfte, damit Sie genau sehen, wie weit dieser Nachweis reicht. Eine Lücke wird als Lücke angezeigt und nie aufgefüllt.
- Maximaler GPU-Speicher
- dieser Lauf fand auf einer CPU-Maschine statt, es gab also keine GPU zu messen
- Verhalten über einen langen Lauf
- jeder Versuch verwendet die kleinsten dokumentierten Einstellungen und ein festes Zeitbudget, daher misst dies, ob es läuft, nicht wie es sich unter Last hält
- Verhalten gegenüber echten Diensten
- dieser Lauf wurde nur gegen Ersatzdienste verifiziert
Das Ende der Aufzeichnung
Die letzten Zeilen der Terminalsitzung, die diesen Befund entschieden hat, genau so, wie sie aufgezeichnet wurden.
4. **Built a local runner** (`run_local.py`) that mocks the `modal` module and serves both the Reac…
5. **Verified the stack:**
   - `GET /status` → **200**
   - `GET /` → **200** (frontend HTML served)
   - `WebSocket /ws` → connected, echoed Opus-tagged binary frames (tag `\x01` prefix)
   - Adapted **e2e test** against the local server: 10 opus chunks sent → **30 chunks received** (`…
6. **All dependency imports verified:** `modal`, `torch`, `moshi`, `sphn`, `fastapi`, `uvicorn`, `a…
**Notes on what did not work:**
- `modal serve` and `modal deploy` require a Modal account and API tokens — these cloud-only comman…
- `sounddevice` requires the system `libportaudio` which is not installed, but this only affects th…
- GPU (CUDA) not available, so the real Moshi model cannot do inference locally — but the API adapt…
**Final result:**
Gesamte Sitzung abspielen, jeder Befehl von einer sauberen Maschine bis zu diesem Punkt.
So wurde getestet
Ein Agent, ein Container, keine menschliche Hilfe. Er installiert das Projekt so, wie es die eigene Dokumentation beschreibt, führt es aus und behebt, was nicht funktioniert. Alles Folgende wurde so aufgezeichnet, wie es geschah: die Terminalsitzung, das Log und der genaue Commit. Die vollständige Methodik.
Stärken und Grenzen
Gemessene Fakten, keine Meinungen. Wie diese Inhalte entstehen.
Was gut lief
- In 1,1 Minuten installiert, schneller als der Median der 230 vergleichbaren Projekte, die Argusic gemessen hat.
- Hat sich von allen 3 Fehlern erholt, ohne dass ein Mensch eingriff, was zeigt, dass die Fehlschläge gut genug dokumentiert sind, um sie zu lösen.
- Lizenz MIT, laut Angabe des Hosts.
Was nicht lief oder unbekannt ist
- Hat einen lauffähigen Zustand nur gegen Ersatzdienste erreicht, daher belegt nichts hier, dass es mit den echten funktioniert.
- Bisher einmal gemessen. Ein einzelner Versuch zeigt, dass es laufen kann, nicht dass es zuverlässig läuft.
Von den 231 Projekten im Bereich ai, die Argusic installiert und zeitlich gemessen hat, belegte quillman Platz 35 bei der Zeit bis zum lauffähigen Zustand, und 152 von 231 erreichten überhaupt einen solchen Zustand.
Ebenfalls getestet, im selben Bereich
Jedes dieser Projekte wurde von Argusic auf einer sauberen Maschine installiert und ausgeführt. Hier erscheint nichts, was nicht getestet wurde.
Laufverlauf
| getestet von | Versuch | Ergebnis | Score | Kosten USD | wann |
|---|---|---|---|---|---|
| Argusic Runner | 1/3 | Läuft mit Mocks | 92,00 | 0,09 |
Themen (von GitHub)
ailanguage-modelpythonserverlessspeech-recognitionspeech-to-text
Badge einbetten
Markdown für die README des Projekts. Es verlinkt hierher zurück; Bedingungen auf der Seite mit den Nutzungsbedingungen.
[](https://argusic.com/subject/quillman)Fragen
- Läuft quillman?
- quillman läuft, mit Mocks als Ersatz für externe Dienste. Argusic hat es auf einer sauberen Maschine in 1 Minuten installiert und gestartet, ist dabei auf 3 Fehler gestoßen und hat die Sitzung aufgezeichnet.
- Wie hat Argusic quillman getestet?
- Auf einer frischen Einwegmaschine, mit jedem Befehl aufgezeichnet und dem Repository fixiert auf Commit 7ed27b446538. Ein Versuch ist aufgezeichnet, und die vollständige Methode steht auf der Seite zur Methodik.
- Was hat der Test von quillman gekostet?
- Der Lauf, der diesen Befund ergab, kostete 0,09 USD: echte Rechen- und Modellkosten, kein Listenpreis pro Million Tokens. Der Betrag ist auf der Seite dieses Laufs aufgezeichnet.
- Wie lange dauert die Installation von quillman?
- 1,1 Minuten in dem Lauf, der diesen Befund entschieden hat, von einer sauberen Maschine bis zum lauffähigen Zustand. Das ist ein gemessener Versuch, kein Durchschnitt.
- Braucht quillman eine GPU?
- Nicht zum Starten. Argusic hat auf einer Maschine ohne GPU einen lauffähigen Zustand erreicht.
- Was geht bei der Installation von quillman schief?
- Im aufgezeichneten Lauf gingen 3 Dinge kaputt, und 3 davon wurden ohne menschliche Hilfe behoben. Jedes davon und die Zeit, die es gekostet hat, ist auf dieser Seite aufgeführt.
- Wie schneidet quillman im Vergleich zu Alternativen ab?
- Von den 231 Projekten im Bereich ai, die Argusic installiert und zeitlich gemessen hat, belegte quillman Platz 35 bei der Zeit bis zum lauffähigen Zustand, und 152 von 231 erreichten überhaupt einen solchen Zustand.
- Wo ist der Nachweis für quillman?
- Der aufgezeichnete Lauf ist auf dieser Seite, jeweils mit Link auf das vollständige Log und die Terminalaufzeichnung, gespeichert mit einem sha256-Fingerabdruck, damit nichts unbemerkt verändert werden kann.